날씨를 확인한 뒤 지역을 고르고, 공공시설 정보를 찾아 조건에 맞는 답을 만드는 일은 검색 한 번으로 끝나지 않습니다. 여러 공공 API의 출력값을 다음 호출의 입력값으로 넘겨야 합니다. 2026년 9월 4일 공개된 KOPA-Bench는 이런 한국 공공 API의 다단계 작업을 145개 실제 과제로 묶었습니다.
연구진이 겨냥한 문제는 단순 지식이 아니라 실행 연결입니다. 공개형 9B 모델도 어떤 API를 먼저 부르고 결과에서 어떤 값을 꺼내 다음 도구에 넣어야 하는지 배우면, 같은 계열의 조정하지 않은 27B 모델에 가까운 성능을 냈다고 보고했습니다.
한국형 도구 호출의 빈칸
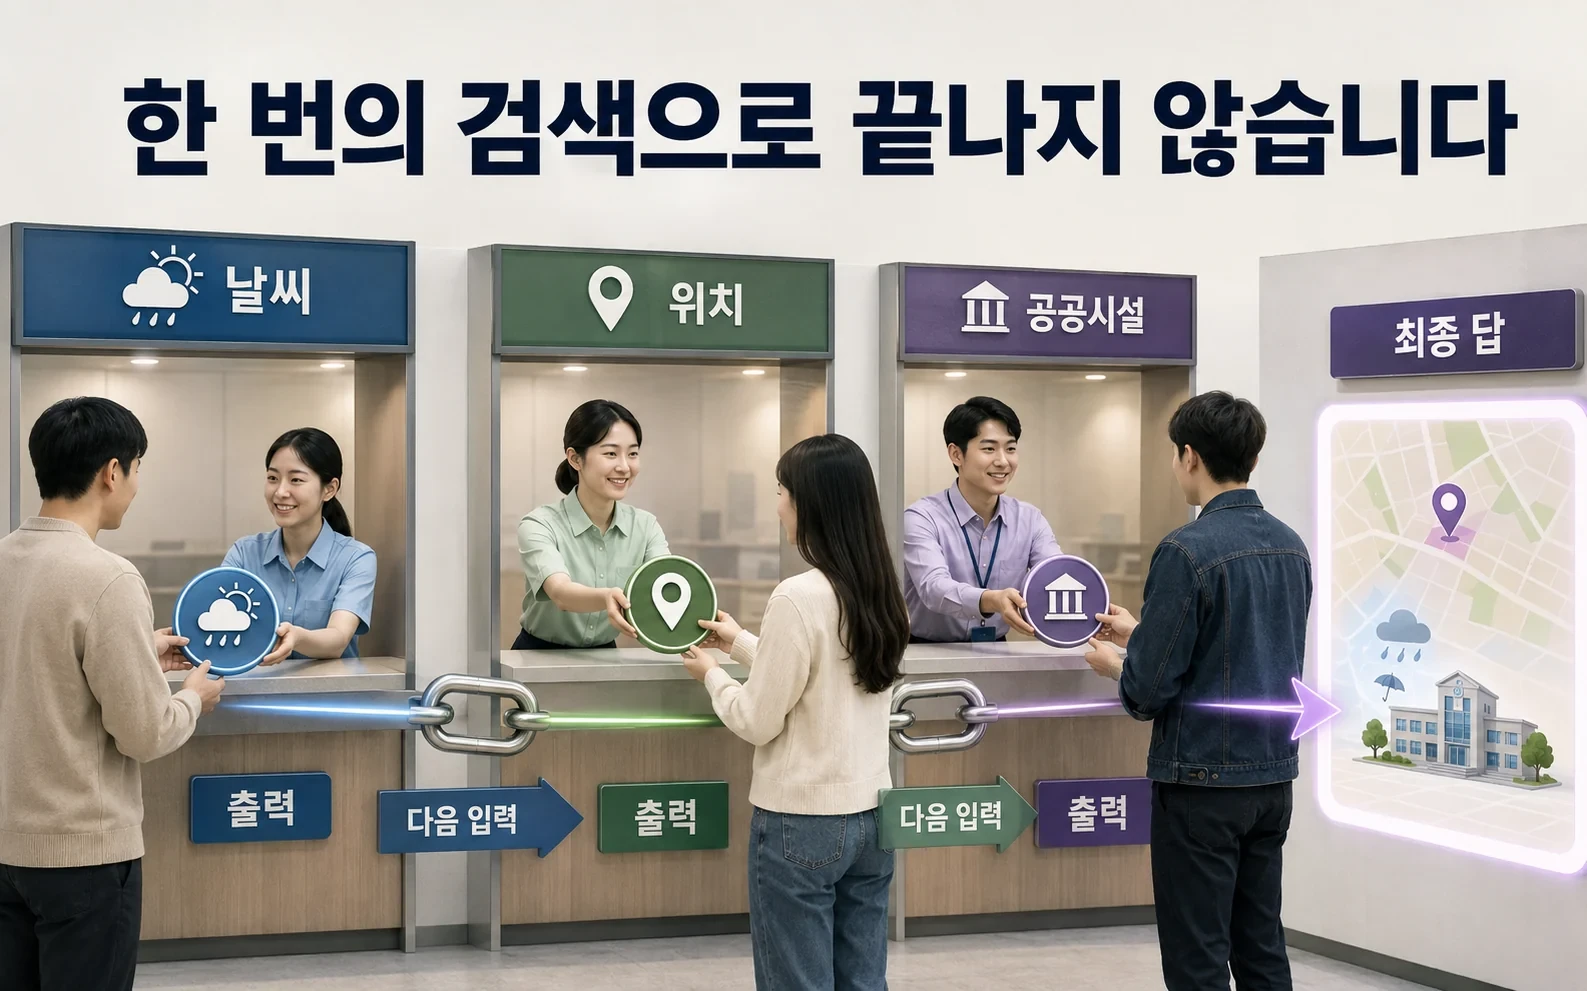
기존 도구 사용 평가는 영어권 서비스와 정적인 모의 API에 치우친 경우가 많았습니다. 한국 공공 데이터는 필드 이름, 행정구역, 인증 방식과 응답 형식이 다르고 실시간으로 값도 바뀝니다. 모델이 문장을 잘 이해하는 것만으로는 부족합니다.
KOPA-Bench는 145개 과제를 실제 호출로 평가합니다. 정답을 맞히는 것뿐 아니라 필요한 도구 순서와 인자를 올바르게 구성했는지 봅니다. 공공기관이 자체 서버의 공개형 모델을 쓰려 할 때, 한국어 문답 점수보다 더 현실적인 시험대입니다.
성공한 연결만 남기는 EDGE
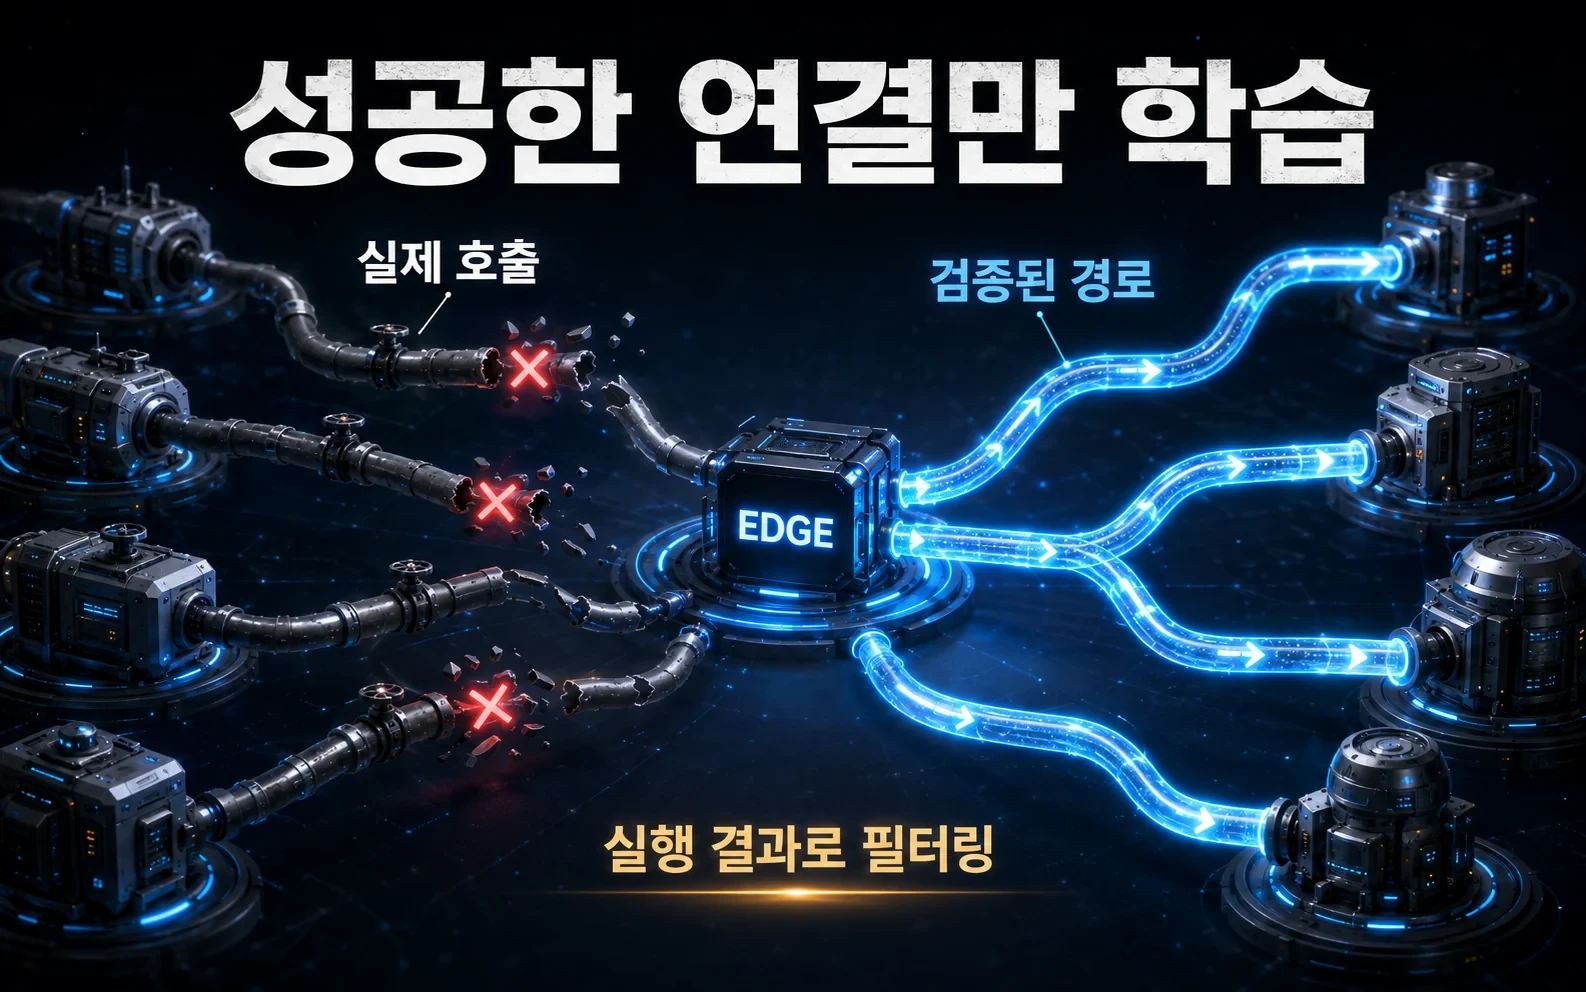
핵심은 EDGE라는 데이터 합성 방식입니다. 한 API의 출력 필드가 다른 API의 입력으로 이어질 가능성을 그래프로 만들고, 실제 호출에 성공한 연결만 남깁니다. 그다음 검증된 연결을 따라 여러 단계의 학습 경로를 만듭니다.
이는 모델이 그럴듯한 호출문을 외우는 대신 실행 가능한 순서를 배우게 합니다. 문서만 보고 합성한 데이터는 필드 이름이 맞아도 서비스에서 실패할 수 있지만, EDGE는 실행 결과를 필터로 사용합니다. 데이터 양보다 실패하지 않는 연결의 품질을 높인 접근입니다.
9B와 27B 사이의 거리
연구진은 합성 데이터로 9B 모델을 GRPO 방식으로 조정했습니다. 그 결과 KOPA-Bench에서 같은 계열의 조정하지 않은 27B 모델에 거의 근접했고, 외부 도구 호출 평가인 BFCL에서도 개선됐다고 밝혔습니다.
여기서 ‘작은 모델이 큰 모델을 이겼다’고 일반화하면 곤란합니다. 비교는 같은 모델 계열과 논문이 정한 과제·설정 안의 결과입니다. 다만 기관 전용 업무에서는 무조건 큰 모델을 사는 것보다 실제 업무 경로를 검증한 데이터가 더 큰 차이를 만들 수 있다는 점은 분명합니다.
공공 서비스에 필요한 다음 시험
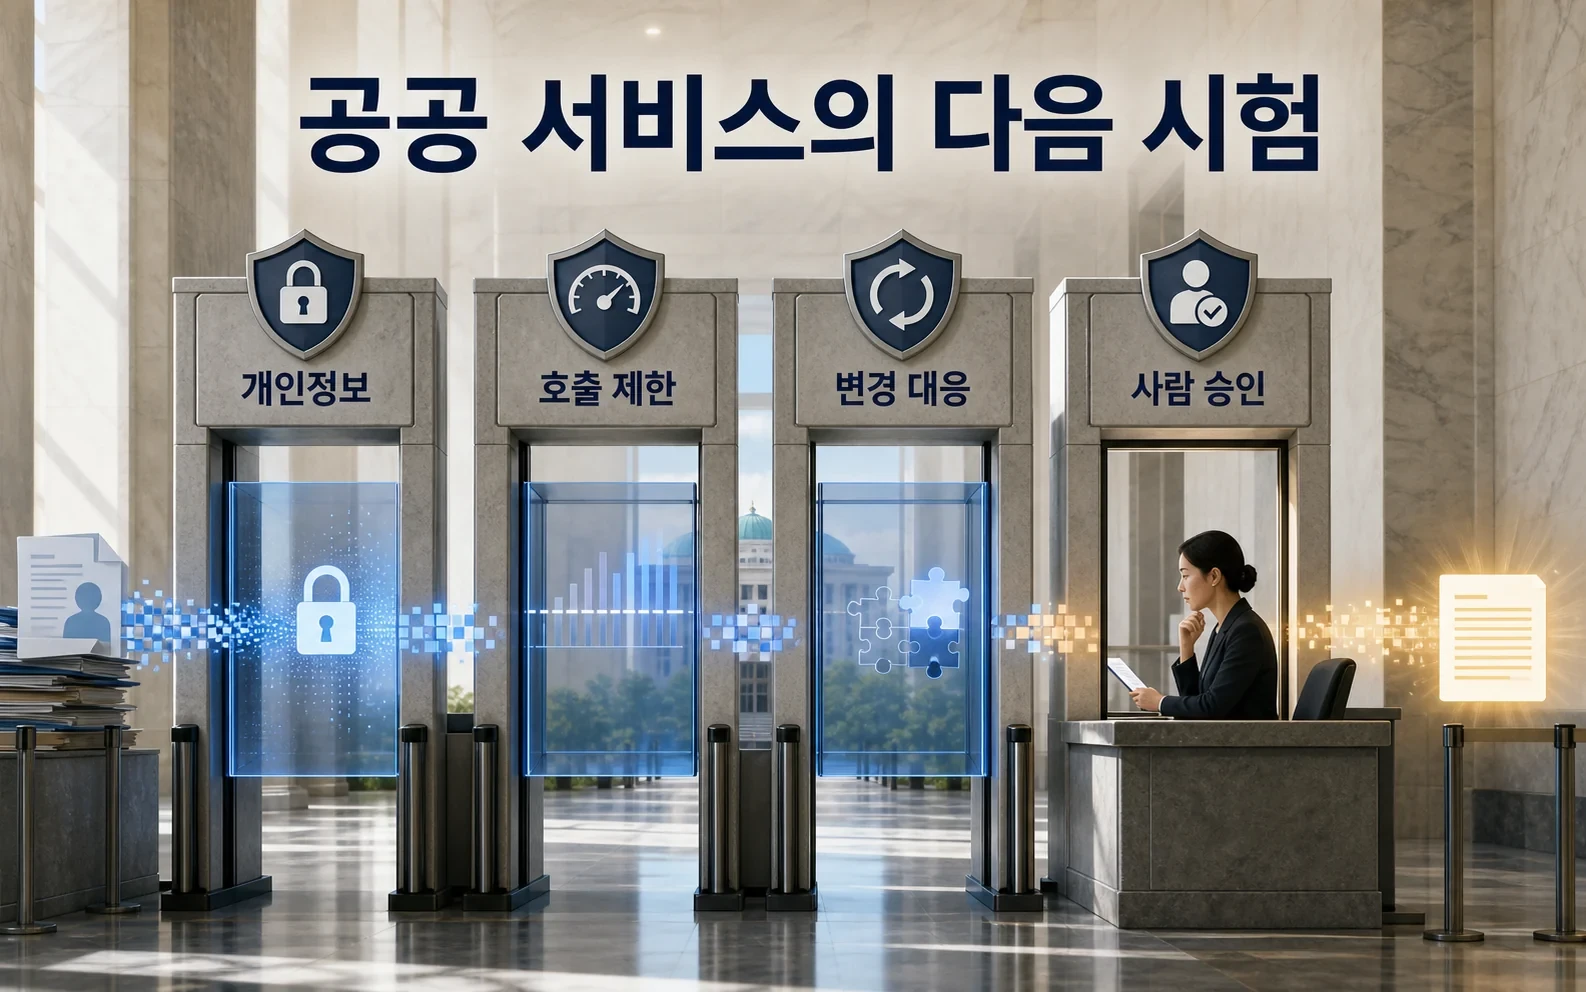
실제 도입에는 개인정보, 호출 제한, 인증키 관리, API 변경 대응이 남습니다. 최신 정보가 필요한 업무일수록 실시간 호출은 유용하지만, 외부 서비스 장애와 잘못된 조합도 함께 들어옵니다. 사람의 승인 없이 민원 처리나 자격 판단을 확정하는 용도로 바로 확대해서는 안 됩니다.
KOPA-Bench의 가치는 완성된 공무원 AI를 만든 데 있지 않습니다. 한국 공공 API를 연속으로 쓰는 능력을 따로 측정할 공통 자를 만든 데 있습니다. 다음 단계는 다른 연구팀의 재현, 실제 기관 환경의 오류율, 규정이 바뀌었을 때의 회복 능력입니다.