사람에게 컵을 집어 달라고 부탁하는 건 쉽습니다. 로봇에게 같은 일을 시키려면 컵이 어디에 있는지, 손을 어떻게 움직일지, 제대로 잡았는지까지 연결해야 합니다. 이런 행동을 사람이 하나씩 시연해 가르치는 데는 시간과 장비가 들죠. 퍼셉트론이 이번 주 공개한 로봇 AI ‘아이작 0.5(Isaac 0.5)’는 그 부담을 동영상 학습으로 줄일 수 있는지 보여주는 사례입니다. 영상을 보고 말하는 AI에서, 본 내용을 행동에 활용하는 AI로 넘어가려는 시도입니다.
로봇 한 시간에 함께 들어가는 사람의 시간
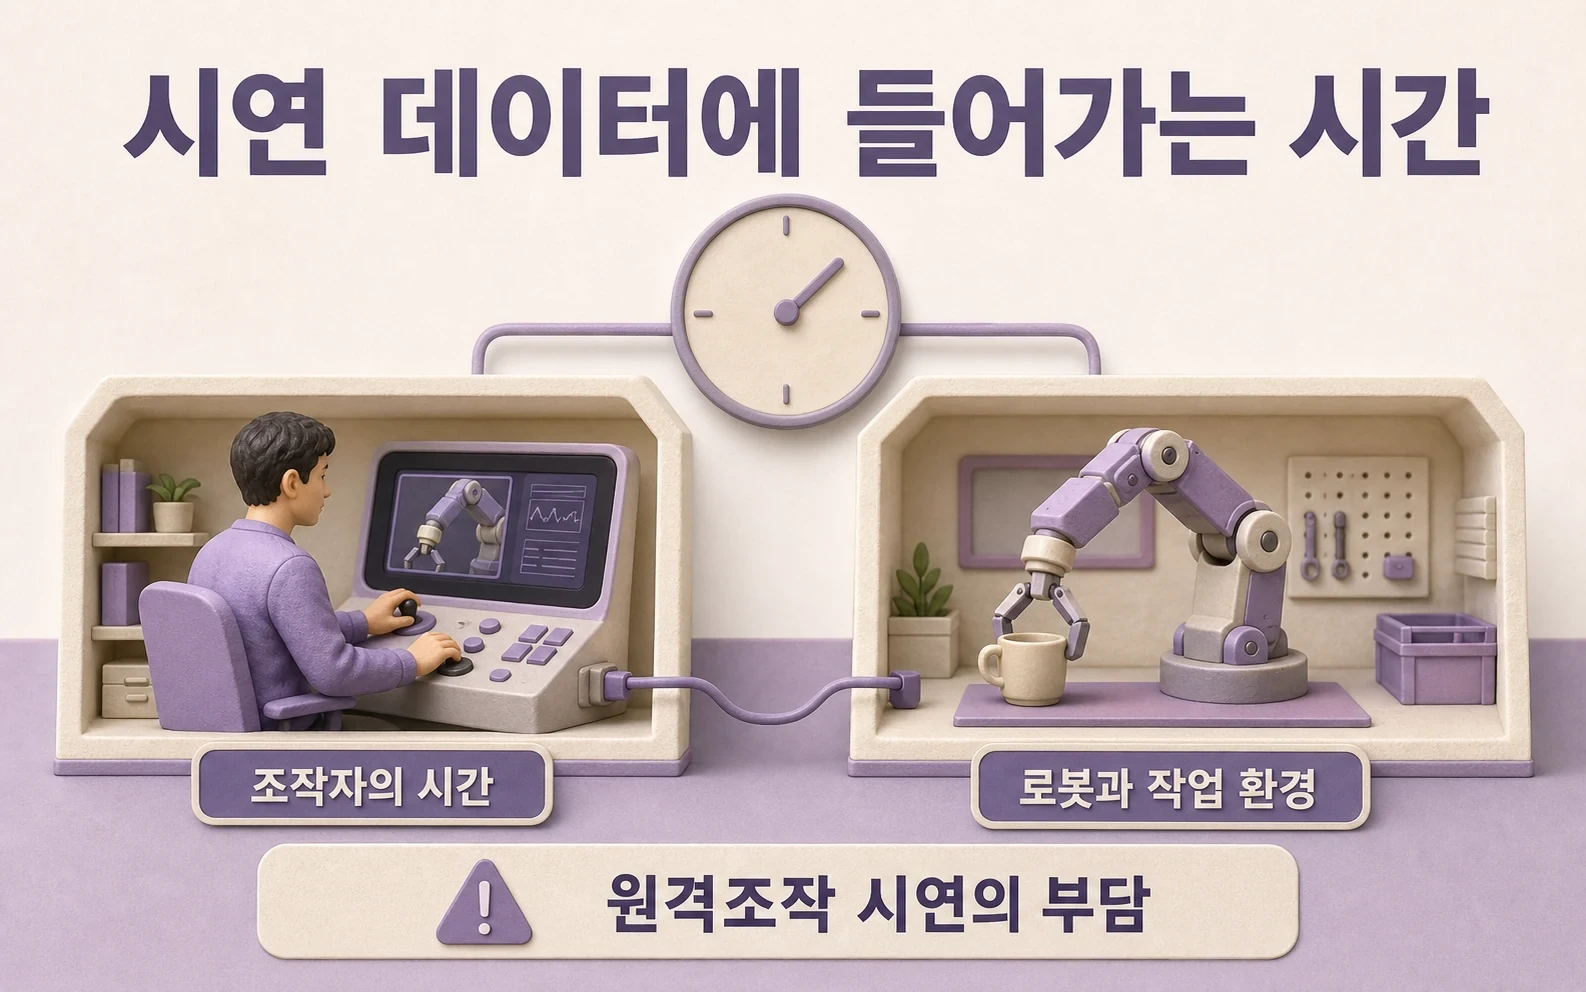
로봇을 가르치는 방법 중 하나는 사람이 원격으로 조작한 행동을 기록하는 것입니다. 기계가 어디를 봤고 어떤 움직임을 했는지 짝지어진 자료를 얻을 수 있어 유용합니다. 대신 한 시간의 데이터를 모으려면 로봇과 조작자, 작업 환경을 함께 준비해야 합니다.
동영상은 상대적으로 풍부합니다. 사람이 물건을 집거나 서랍을 여는 장면에서 사물의 위치와 움직임을 배울 수 있죠. 하지만 화면만으로 로봇 관절에 어떤 명령을 내려야 하는지 곧바로 알 수는 없습니다. 사람 손과 로봇 집게의 구조도 다릅니다.
그래서 중요한 질문은 ‘시연을 전부 없앨 수 있나’보다 ‘영상에서 배운 내용을 활용해 필요한 시연을 줄일 수 있나’입니다. 이번 연구가 살펴본 것도 이 관계입니다.
보는 능력과 움직이는 능력의 연결
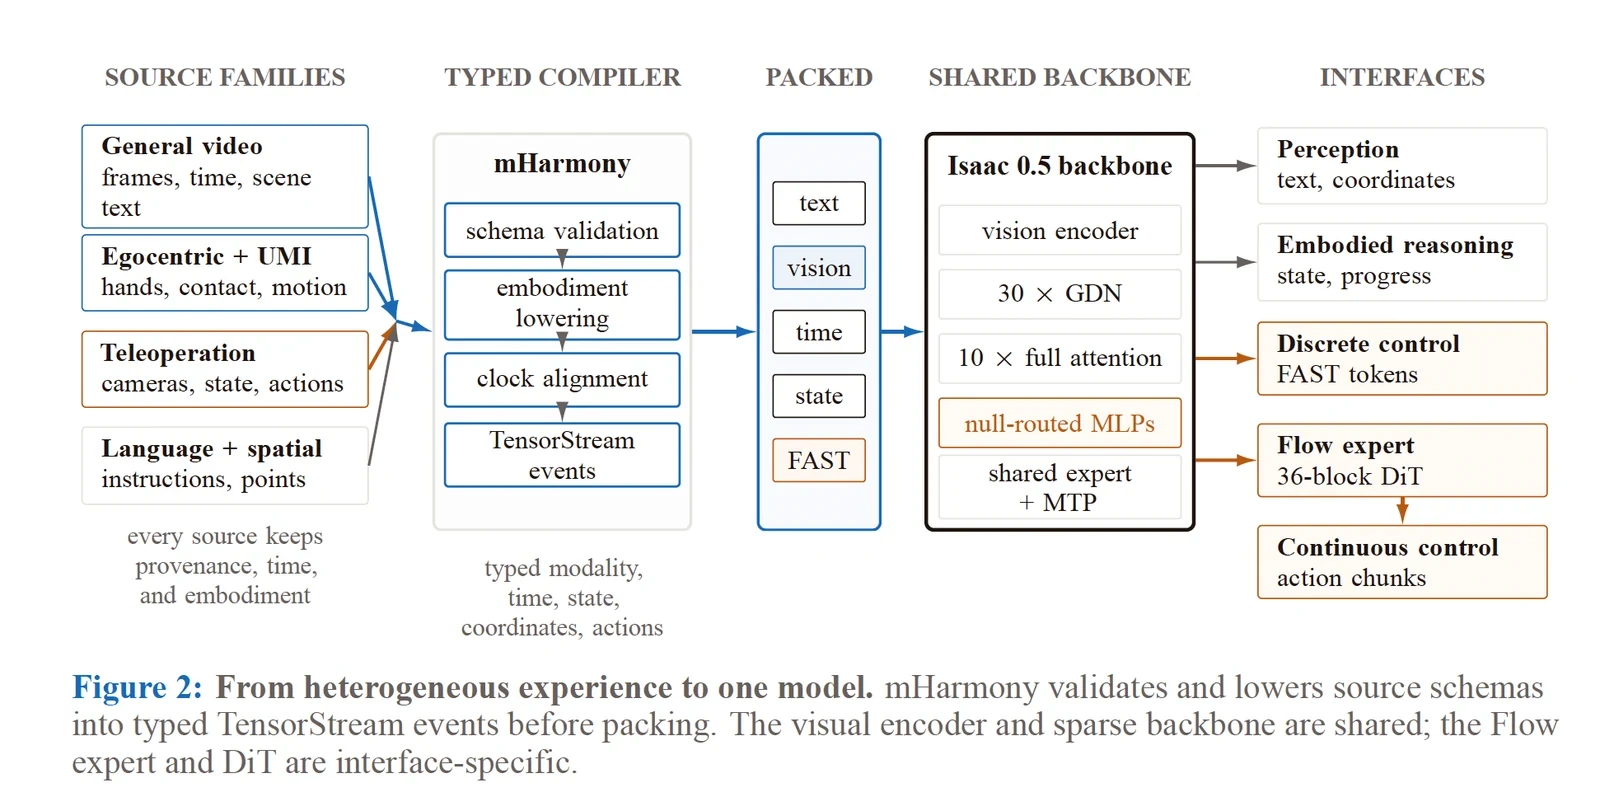
아이작 0.5는 영상 이해, 공간 판단, 작업 진행 상황 추정과 로봇 제어를 하나의 모델에서 함께 학습하도록 만들었습니다. 연구팀은 일반 영상뿐 아니라 사람 시점의 작업 영상, 조작 도구를 이용한 데이터, 로봇 경험도 사용했다고 설명합니다.
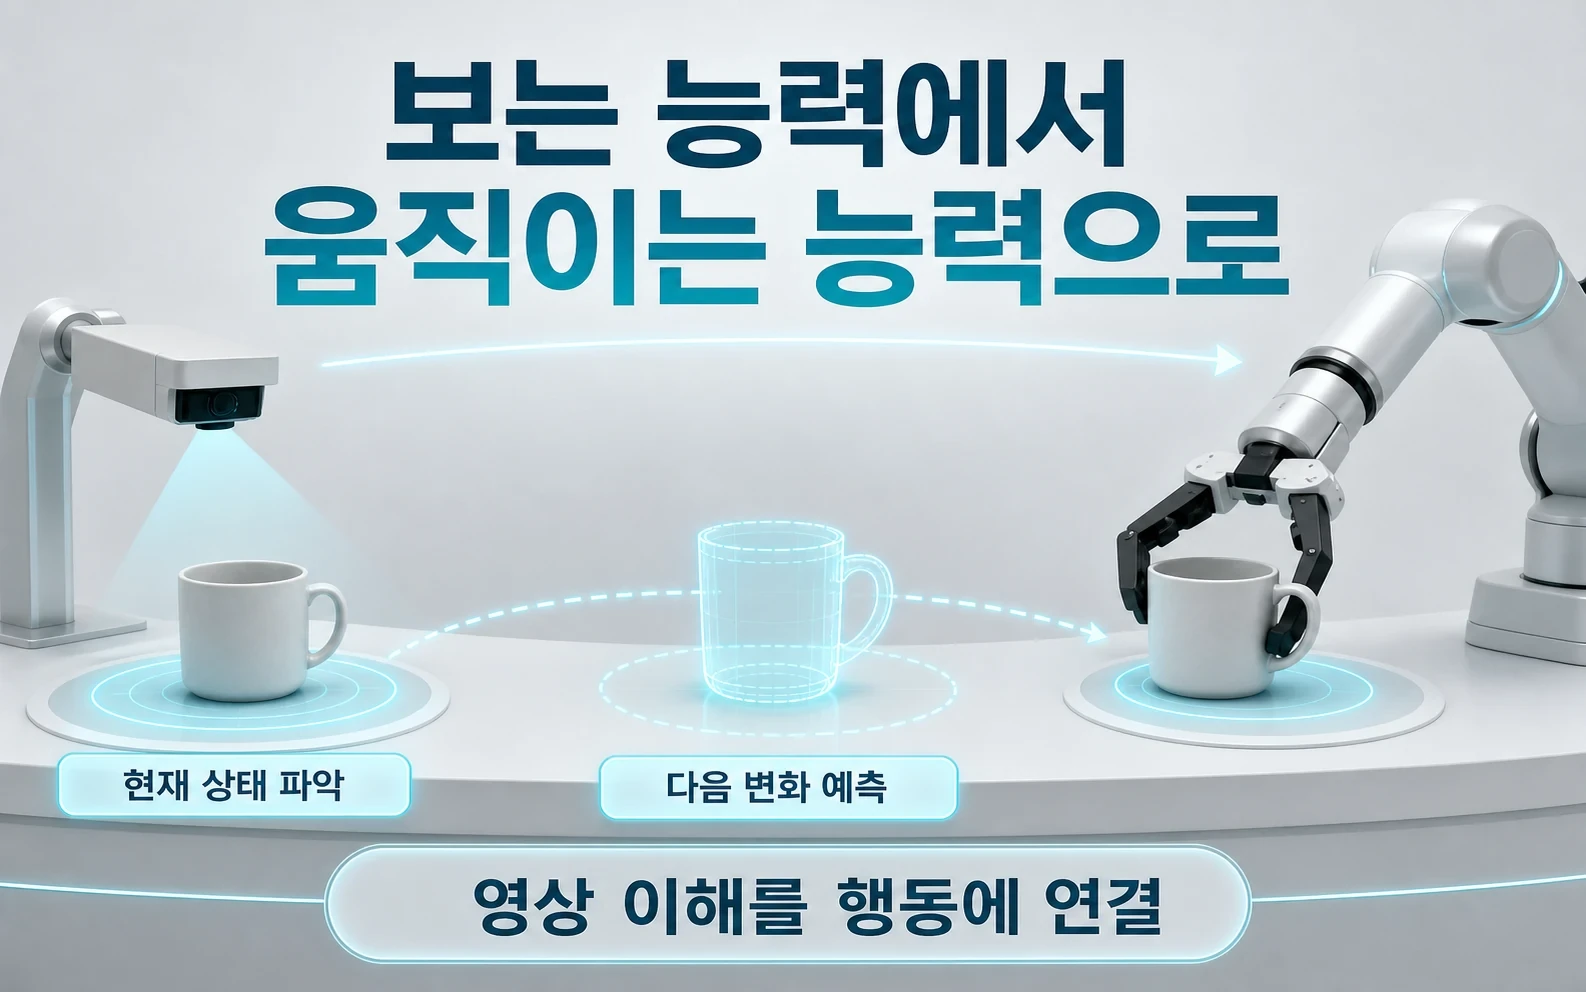
영상 학습에서는 다음 장면에 어떤 변화가 생길지를 예측합니다. 서랍이 열렸는지, 물체가 잡혔는지처럼 작업에 의미 있는 변화입니다. 이런 시각적 이해가 행동을 만드는 부분에도 쓰이도록 연결한 것이죠.
예를 들어 집게가 컵에 닿았다는 것과 컵을 안정적으로 잡았다는 것은 다릅니다. 다음 행동을 정하려면 현재 상태를 구별해야 합니다. 영상 이해와 제어를 함께 다룬다는 말은 이런 연결을 배우게 한다는 뜻입니다. 단순히 로봇에 대화형 챗봇을 붙이는 것과는 목표가 다릅니다.
시연 시간을 줄인 실험의 조건
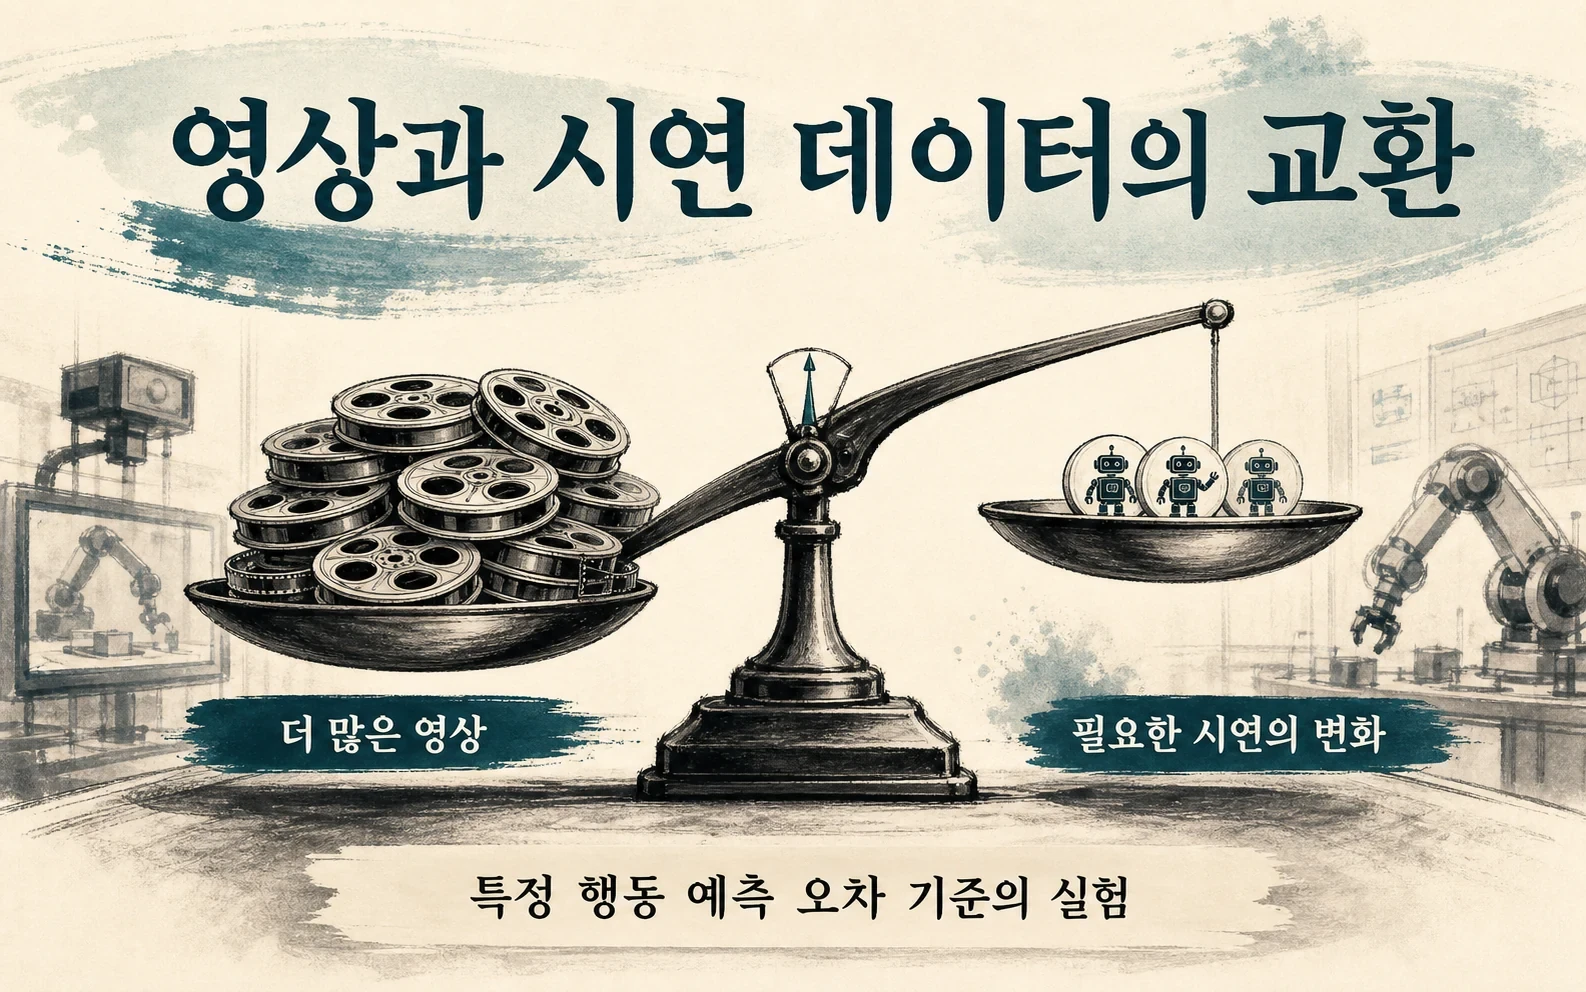
연구팀은 영상과 원격조작 데이터를 섞는 비중을 바꾸며 학습 결과를 비교했습니다. 공개 모델 카드에는 일반 영상이 1,000시간일 때 약 5,900시간의 원격조작 시연이 필요했던 기준에, 일반 영상을 100만 시간으로 늘리면 약 28시간의 시연으로 도달했다는 결과가 담겨 있습니다.
여기서 기준은 실제 공장 생산량이 아니라, 학습에 쓰지 않은 로봇 행동을 얼마나 잘 예측하는지를 보는 오차 지표 2.50입니다. 논문에서는 다른 종류의 영상도 정해진 비율로 함께 늘렸습니다. 일반 영상만 추가하고 나머지 조건은 모두 그대로 둔 비교가 아닙니다.
시연 시간이 크게 줄었다는 점은 흥미롭지만, 전체 비용도 같은 비율로 줄었다고 말할 수는 없습니다. 늘어난 영상을 확보하고 처리하는 비용도 있으니까요. 이 결과의 가치는 사람이 직접 가르치는 데이터와 영상 데이터 사이에 어떤 교환이 가능한지 구체적으로 살펴봤다는 데 있습니다.
공개 모델에서 실제 작업장까지
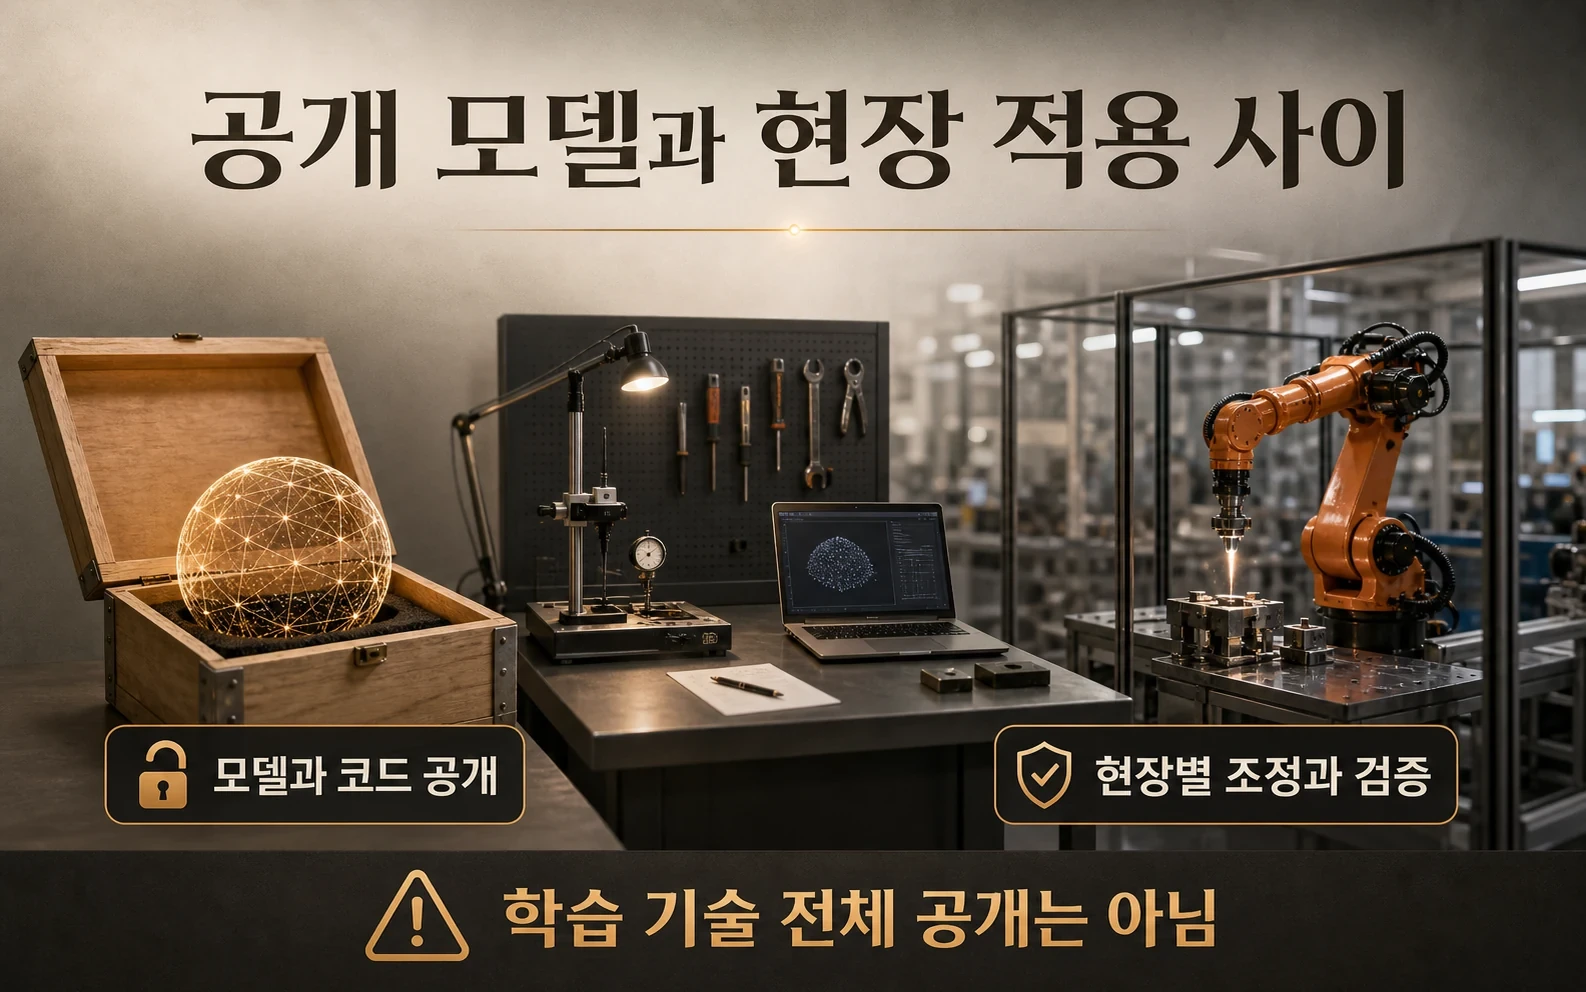
퍼셉트론은 모델 가중치와 활용·조정 코드 등을 공개했습니다. 다만 학습에 사용한 모든 기술이 열린 것은 아닙니다. 논문은 영상에서 학습 목표를 만드는 일부 방식이 비공개라고 설명합니다. 다른 팀이 모델을 받아 검토할 수 있다는 것과 학습 전 과정을 그대로 재현할 수 있다는 것은 구별해야 합니다.
실제 로봇에 적용할 때도 카메라 위치, 집게 구조, 작업 속도에 맞는 조정이 필요합니다. 실험 성능은 업체가 보고한 결과이므로, 낯선 환경에서의 성공률이나 안전성이 독립적으로 입증됐다고 볼 수는 없습니다.
그럼에도 산업적으로 눈여겨볼 이유는 있습니다. 새로운 작업을 가르칠 때 드는 시연 부담을 줄일 수 있다면, 로봇을 투입하기 어려웠던 업무에도 적용을 검토할 여지가 생기기 때문입니다. 앞으로 볼 장면은 화려한 시연 한 번보다, 서로 다른 현장에서 반복해서 일을 해내는 모습입니다.