2026년 9월 1일 미국 에너지부는 브룩헤이븐 국립연구소가 이끄는 전력망 AI 프로젝트에 1,420만 달러를 투입한다고 발표했습니다. 연구 기간은 3년입니다. 목표는 전력망의 가능한 시나리오를 하루에 10억 개까지 검토할 수 있는 기반 모델을 만드는 것입니다.
이 숫자를 전력망 운영자가 내일 바로 10억 개의 결정을 AI에 맡긴다는 뜻으로 읽으면 곤란합니다. 현재 공개된 것은 Genesis Mission 2단계의 연구 계획과 목표입니다. 핵심 변화는 전력망 계산을 한 번씩 따로 돌리는 방식에서, 많은 후보를 빠르게 걸러내는 AI와 정밀 시뮬레이션을 결합하는 방식으로 옮기려는 데 있습니다.
전력망 계산이 느린 이유
전력망은 발전량만 맞추면 되는 거대한 배터리가 아닙니다. 태양광과 풍력의 변동, 송전선의 용량, 수요의 시간대, 발전기의 고장과 복구가 동시에 얽혀 있습니다. 새로운 발전소나 대형 부하를 연결할 때도 “평균적으로 충분한가”가 아니라 여러 조건에서 전압과 주파수, 선로 흐름이 안전 범위에 남는지 확인해야 합니다.
이 과정에서 후보 하나를 정밀하게 계산하는 데 시간이 걸리면, 검토할 수 있는 설계의 수가 줄어듭니다. GridFM이 맡으려는 일은 최종 판정을 대신하는 것이 아니라, 많은 입력과 과거 계산 결과에서 유망한 후보를 먼저 좁히는 것입니다. 브룩헤이븐은 새 부하·발전·저장장치 시나리오를 학습 데이터와 연결해 이 탐색층을 만들 계획입니다.
10억 시나리오는 운영 명령이 아니다
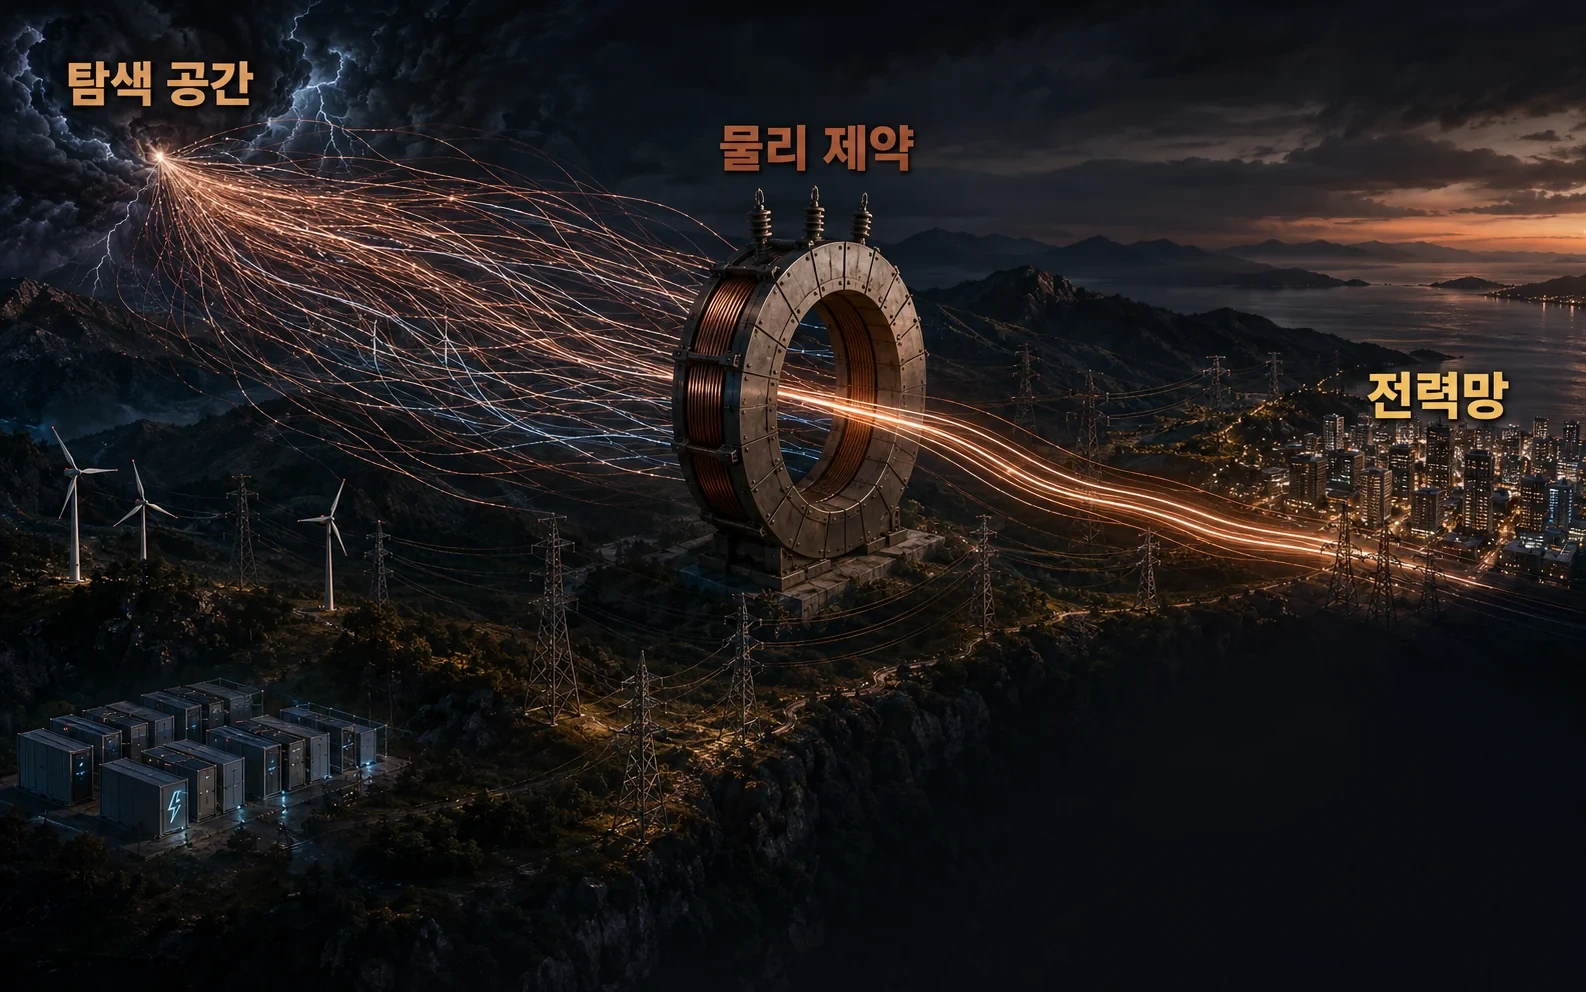
프로젝트가 말하는 하루 10억 시나리오는 계산·선별 능력의 목표입니다. 발전소를 실제로 켜고 끄는 명령이 10억 번 나온다는 뜻이 아닙니다. AI가 후보를 빠르게 줄인 뒤, 계통 운영자가 승인할 수 있는 모델과 도구로 다시 정확성과 안정성을 확인하는 단계가 필요합니다.
이 구분은 중요합니다. 시뮬레이션 데이터에 드문 고장이나 극단적인 날씨가 충분히 들어 있지 않으면 AI는 평소에는 그럴듯하지만 위험한 예외에 약할 수 있습니다. 따라서 속도 목표와 운영 신뢰성을 같은 숫자로 묶어서는 안 됩니다.
여러 기관이 함께 만들어야 하는 이유
브룩헤이븐이 공개한 협력 구상에는 미국 에너지부, 대학·연구소, 전력 유틸리티, AI·클라우드 기업이 함께 들어옵니다. 전력망 데이터는 한 기관에만 있지 않고, 계통 운영 기록과 자산 정보, 연구용 모델의 형식도 서로 다릅니다. 연구실의 모델이 현장 의사결정에 쓰이려면 데이터의 출처와 시간 기준, 보안 경계를 함께 맞춰야 합니다.
이 구조는 AI 프로젝트의 성패가 모델 크기만으로 결정되지 않는다는 점을 보여 줍니다. 실제 전력망에는 공개할 수 없는 설비 정보와 지역별 규칙이 있으므로, 성능이 좋아도 데이터를 안전하게 다루고 결과를 설명할 수 없으면 배치하기 어렵습니다.
다음에 확인할 숫자
다음 검증 지점은 “10억” 자체가 아닙니다. 첫째, 어떤 전력망과 어떤 시간 해상도에서 그 시나리오를 만들었는지 확인해야 합니다. 둘째, AI가 고른 후보가 기존 정밀 시뮬레이션과 얼마나 일치하는지, 특히 희귀한 고장 조건에서 얼마나 안전한지 봐야 합니다. 셋째, 운영자가 결과를 승인하고 되돌릴 수 있는 절차가 마련되는지 확인해야 합니다.
성공한다면 전력망 계획은 몇 개의 큰 설계를 오래 검토하는 일에서, 훨씬 넓은 후보 공간을 먼저 탐색하고 검증하는 일로 바뀔 수 있습니다. 다만 2026년 9월 현재 GridFM은 연구 프로젝트입니다. 빠른 계산이 곧 안전한 운영을 보장하지 않는다는 경계가 이 기술의 가장 중요한 조건입니다.