데이터센터는 전기를 쓰는 시간과 양을 바꾸기 어려운 거대한 고정 부하로 여겨집니다. 하지만 모든 AI 작업이 지금 당장 끝나야 하는 것은 아닙니다. 호주에서 2026년 9월 10일 시작된 파일럿은 전력망이 바쁠 때 덜 급한 GPU 작업을 늦추거나 옮겨 데이터센터가 수요반응 자원처럼 움직일 수 있는지 시험합니다.
GPU 작업에도 우선순위가 있다
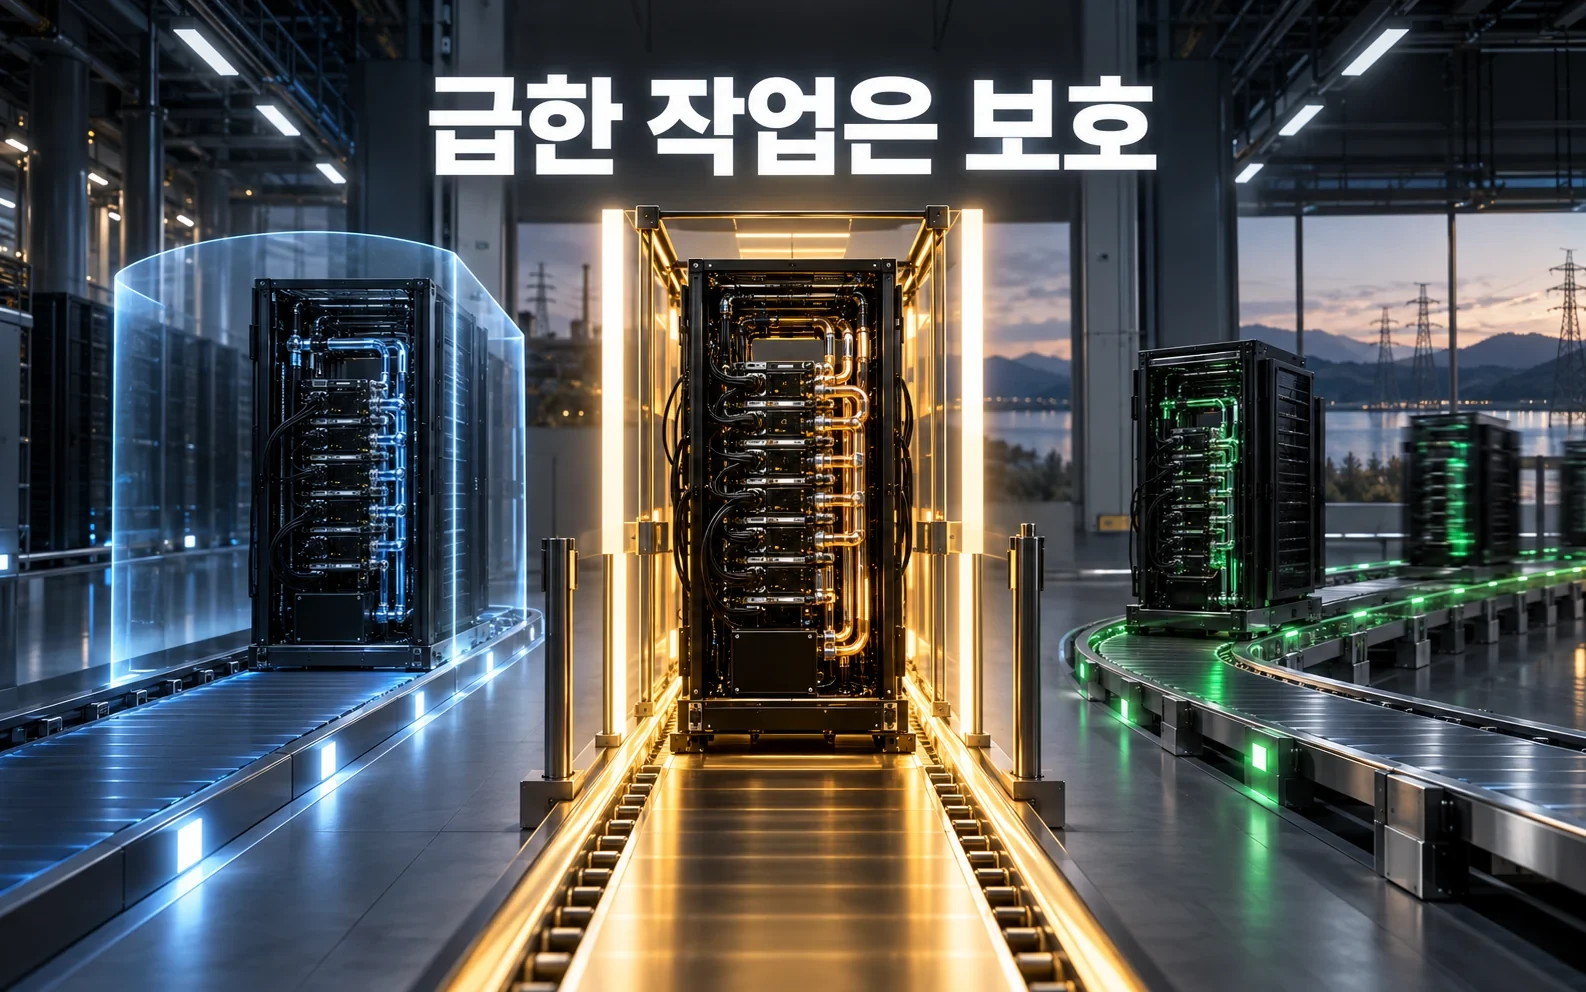
실시간 추론과 긴급한 고객 작업은 지연되면 안 되지만 대규모 학습, 배치 분석과 일부 실험은 몇 분 또는 몇 시간 옮길 수 있습니다. FlexSysAI는 작업을 중요도에 따라 Flex Tier로 나누고 보호 작업은 그대로 두며 탄력 작업만 조절합니다.
CSIRO가 공개한 실증 화면에서는 여섯 GPU를 감속하고 하나는 끄며, 중요 작업을 수행하는 GPU 하나는 계속 돌립니다. 전체 클러스터를 한꺼번에 끄는 방식이 아니라 서비스 영향이 적은 부분을 골라 움직이는 접근입니다.
전력망 신호와 스케줄러를 연결
플랫폼은 전력시장 가격과 계통 상태를 받아 GPU 스케줄러에 전달합니다. 전력이 부족하거나 비싼 시간에는 탄력 작업을 감속하고, 여유가 생기면 다시 늘립니다. 여러 장소가 있다면 전력이 더 풍부한 데이터센터로 작업을 옮길 수도 있습니다.
이 방식은 발전소를 새로 짓는 것과 다릅니다. 이미 연결된 전력망의 가장 혼잡한 짧은 시간대를 피해서 같은 설비로 더 많은 연결을 수용할 여지를 만드는 수요 관리입니다.
20~50%는 절감 실적이 아니다
FlexSysAI는 ResetData의 NVIDIA H200 환경에서 전력망 신호 뒤 수초 안에 작업을 20~50% 조절할 잠재력이 있다고 초기 모델링으로 추정했습니다. 이는 연간 전력 사용량이 같은 비율로 줄었다는 뜻도, 전기요금이 그만큼 낮아졌다는 뜻도 아닙니다.
네트워크가 가장 힘든 시간은 연중 0.25~5%에 불과할 수 있다고 발표는 설명합니다. 짧은 피크를 넘기는 데는 큰 가치가 있지만, 작업 지연과 이동 비용을 함께 계산해야 합니다.
실증이 답해야 할 세 가지
첫째는 정말 서비스 품질을 해치지 않고 전력을 줄일 수 있는가입니다. 둘째는 같은 작업을 나중에 몰아서 처리할 때 새 피크가 생기지 않는가입니다. 셋째는 계통 운영자가 이 유연성에 얼마를 지불하고 연결 계획에 반영할 수 있는가입니다.
CSIRO와 퀸즐랜드대는 운영 데이터를 독립 분석할 예정입니다. 그 결과가 나오기 전까지 이번 소식은 상용 절감 성과가 아니라 살아 있는 H200 클러스터에서 시작한 검증입니다. AI 인프라의 경쟁력이 GPU 수뿐 아니라 언제 전기를 쓰는지로 넓어지고 있습니다.