AI에게 질문 하나를 하는 비용과 업무 하나를 끝까지 맡기는 비용은 꽤 다릅니다. 문서를 읽고, 필요한 자료를 찾고, 결과를 만들고, 오류를 고치는 동안 모델을 여러 번 호출해야 하기 때문입니다. 한 번 쓸 때는 작아 보이던 요금도 이런 일이 수천 번 반복되면 서비스의 수익성을 좌우합니다.
2026년 8월 26일 공개된 Z.ai의 ‘GLM-5.3-Flash’는 이 부담을 낮추려는 모델입니다. 글과 이미지를 함께 다루는 기능을 갖췄고, 외부 서비스인 LM Studio도 같은 날 공급을 알렸습니다. 단순히 답변을 싸게 생성하는 모델이라기보다, 여러 자료를 읽고 도구를 쓰는 AI 업무에 어느 정도 비용으로 투입할 수 있는지가 관심을 끄는 제품입니다.
9월 1일 확인한 LM Studio 요금은 100만 토큰당 입력 0.15달러, 출력 0.50달러입니다. 같은 서비스의 GLM-5.2는 각각 1.50달러와 4.50달러입니다. 입력 단가는 10분의 1, 출력은 9분의 1 수준입니다. 여기서 토큰은 AI가 글을 처리할 때 나누어 읽고 생성하는 단위로, 한 글자나 한 단어와 정확히 일치하지는 않습니다.
저렴한 답변에서 반복 가능한 업무로
자료를 많이 읽어야 하는 작업에서는 입력 요금 차이가 특히 중요합니다. 예를 들어 여러 업체의 제안서를 비교하려면 질문 한 줄보다 훨씬 긴 원문을 AI에 전달해야 합니다. 추가 질문을 하거나 결과를 검토하는 과정에서도 문서와 이전 작업 내용이 다시 입력될 수 있습니다.
GLM-5.3-Flash는 이미지 입력도 지원합니다. 문서에 포함된 화면이나 그림을 글과 함께 다룰 수 있어, 모든 내용을 사람이 먼저 텍스트로 옮겨야 하는 부담을 줄일 여지가 있습니다. 다만 실제 스캔 문서나 복잡한 화면을 얼마나 정확히 읽는지는 자료의 상태와 작업 종류에 따라 확인해야 합니다. 이미지 입력이 가능하다는 것과 어떤 문서든 오류 없이 이해한다는 것은 다릅니다.
LM Studio가 안내한 문맥 길이는 최대 100만 토큰입니다. 한 번의 작업에서 많은 내용을 함께 참고할 수 있다는 뜻입니다. 여러 파일을 오가며 일하는 에이전트에 유용한 조건이지만, 입력 가능한 분량 전체를 똑같이 정확하게 활용한다는 보증은 아닙니다.
긴 자료를 다루는 비용을 줄이는 설계
긴 문서를 처리할 때 AI는 어느 부분이 지금의 질문과 관계있는지 찾아야 합니다. 입력이 길어질수록 서로 비교하고 참조해야 할 정보도 많아집니다. 문맥 길이를 늘려 놓기만 하면 계산과 메모리 부담이 커질 수 있는 이유입니다.
Z.ai는 이번 모델에서 필요한 부분을 골라 참조하는 희소 어텐션과, 긴 입력의 계산 부담을 낮추는 선형 어텐션을 함께 사용했다고 설명했습니다. 모든 정보를 같은 방식으로 처리하지 않고, 필요한 정확도와 처리 효율을 함께 얻으려는 설계입니다. 회사가 제시한 성능 우위는 별도 검증이 필요하지만, 긴 작업을 저렴하게 제공하려면 모델 구조부터 달라져야 한다는 방향은 드러납니다.
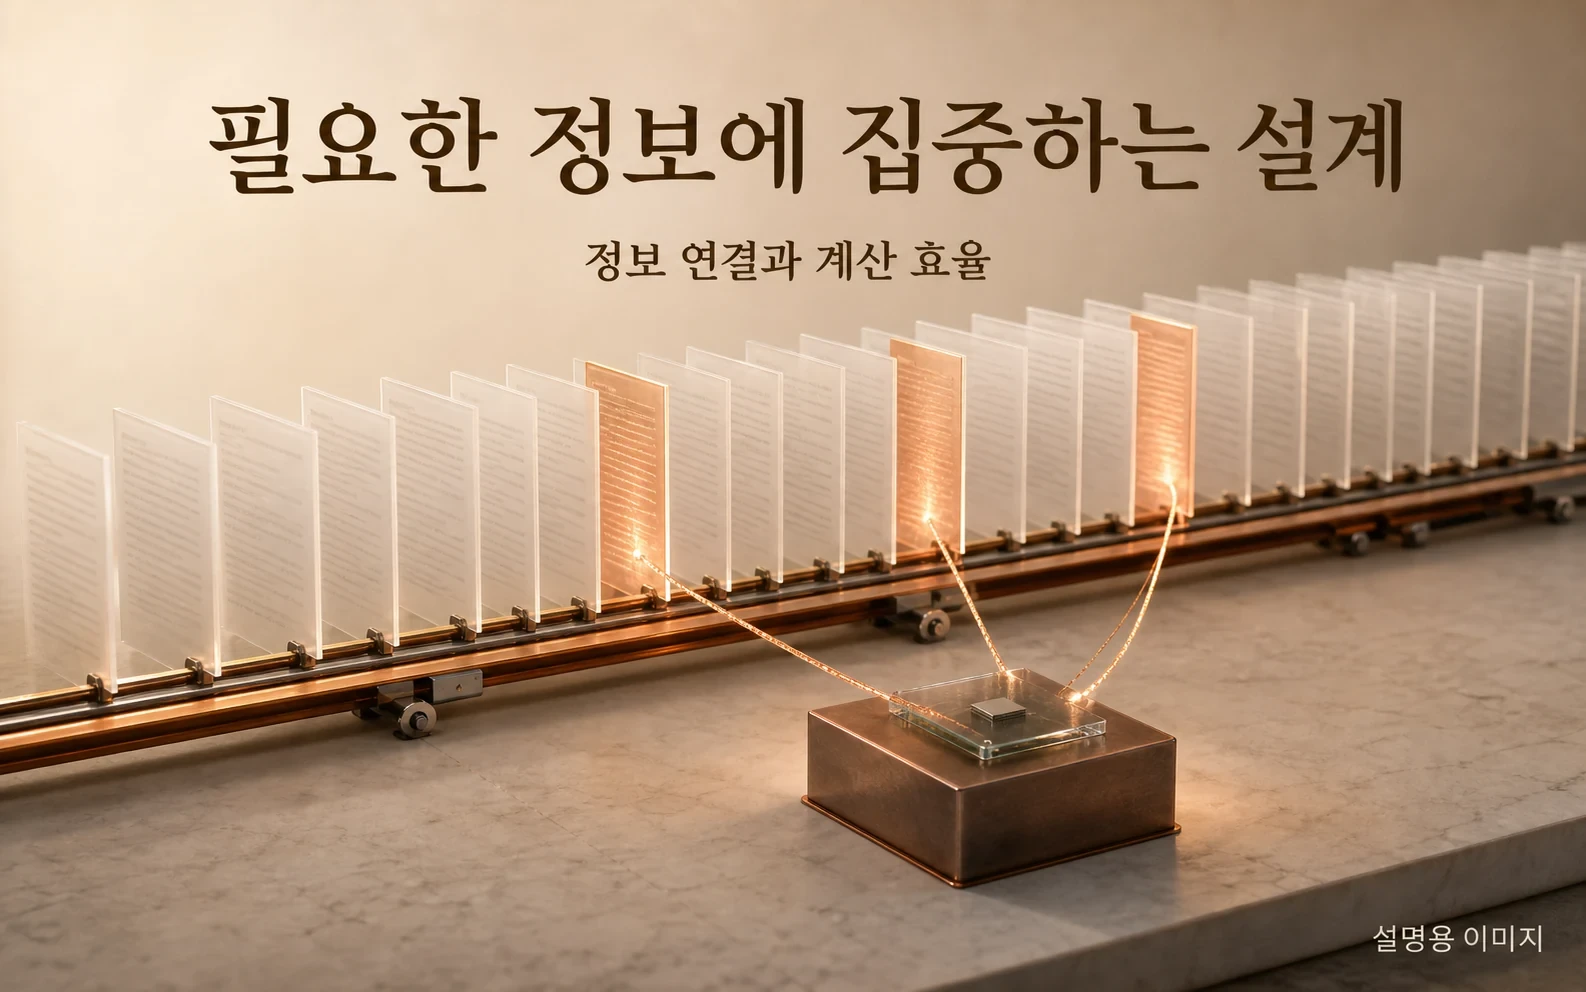
정보 사이의 연결을 효율적으로 처리해 계산 부담을 줄이는 발상을 표현했습니다. GLM 내부 구조를 그대로 재현한 도면은 아닙니다.
이런 비용 절감은 AI를 적용할 수 있는 업무의 범위를 넓힐 수 있습니다. 처리할 문서는 많지만 건당 가치가 크지 않아 사람이 일부만 확인하던 업무도 후보가 됩니다. 반복적인 자료 분류나 비교에 드는 비용이 낮아지면, 필요한 경우를 골라 사람에게 넘기는 서비스를 설계하기가 수월해집니다.
실제 비용은 일을 끝낸 뒤의 계산
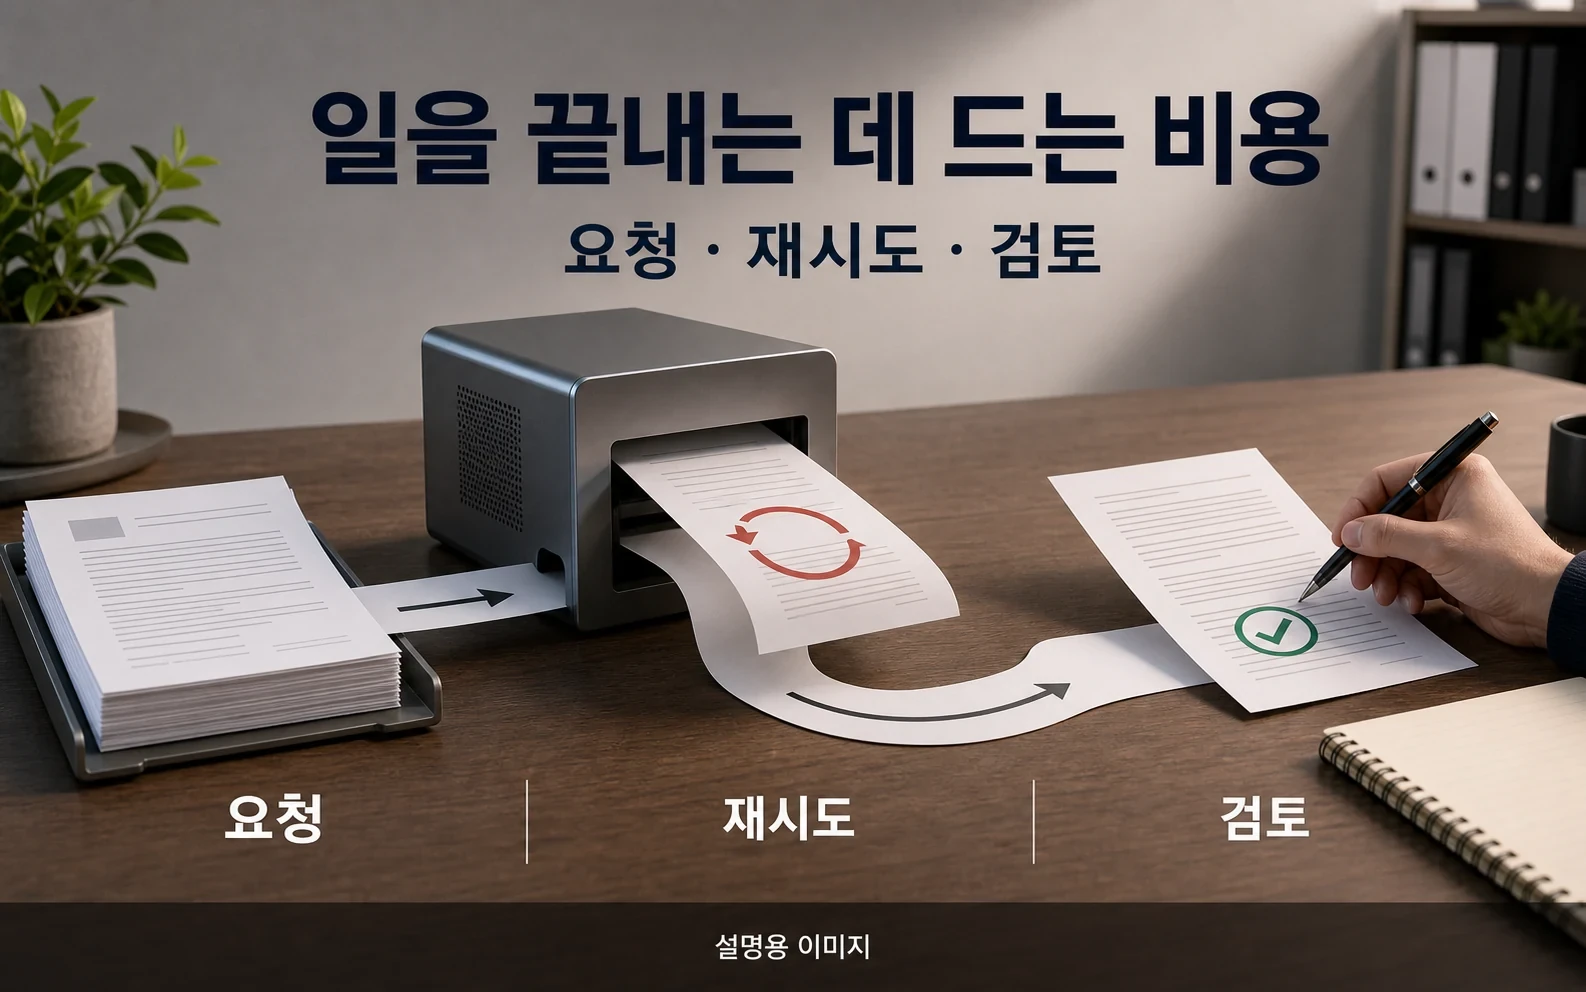
그렇다고 단가가 10분의 1이면 업무 비용도 무조건 10분의 1이 되는 것은 아닙니다. 답을 잘못 만들어 여러 번 다시 시키거나, 불필요하게 긴 추론을 하거나, 결과를 사람이 오래 검토해야 한다면 절감 효과가 줄어듭니다. 웹 검색이나 외부 도구 사용료가 따로 붙는 작업도 있습니다.
비교할 때는 같은 문서와 같은 과제를 주고, 쓸 수 있는 결과가 나올 때까지 든 비용과 시간을 보는 편이 낫습니다. 호출 한 번이 비싼 모델이 한 번에 해결하면 더 경제적일 수 있고, 상대적으로 저렴한 모델이 충분히 잘하는 작업이라면 굳이 비싼 모델을 쓸 이유가 없습니다.
실행 위치도 구분해야 합니다. LM Studio가 이 모델에 제공하는 것은 미국 기반 클라우드 추론입니다. 기본적으로 데이터를 보관하지 않는 ZDR 정책을 안내하고 있지만, 이는 내 컴퓨터 밖으로 데이터가 나가지 않는 로컬 실행과는 다릅니다. 업무 자료를 맡길 때는 가격과 함께 조직의 데이터 처리 기준도 확인해야 합니다.
GLM-5.3-Flash의 의미는 모든 일을 가장 싸게 해결한다고 입증했다는 데 있지 않습니다. 이미지와 긴 자료를 다루는 AI를 실제로 낮은 단가에 쓸 선택지가 생겼다는 데 있습니다. 그 선택지가 유용한지는 벤치마크 순위보다, 우리 업무에서 사람의 시간을 얼마나 덜 쓰게 하는지로 확인할 수 있습니다.
참고자료
- Z.ai, 「GLM-5.3-Flash」 공식 모델카드
- LM Studio, 「Bionic Pricing」, 2026년 9월 1일 확인
- 9to5Mac, 「LM Studio adds GLM-5.3-Flash to Bionic with image support and 1M-token context」, 2026년 8월 26일