코딩 에이전트가 코드를 만들고 바로 실행하는 흐름에 작은 검문소를 하나 더하는 연구가 나왔습니다. 2026년 9월 5일 공개된 프리프린트는 에이전트의 출력 토큰만 읽는 작은 draft 모델을 두고, 실행 전에 실패 가능성이 높은 궤적을 거부하도록 했습니다.
실험에서 보고된 변화는 실행 오류 6~8%포인트 감소, 토큰 비용 14~19% 감소였습니다. 대상은 Qwen3-Coder-480B와 Claude 3.5 Sonnet 계열의 코딩 에이전트였고, 아직 제품 보증이나 모든 저장소에 대한 일반 법칙은 아닙니다.
큰 모델의 내부를 보지 않는 게이트
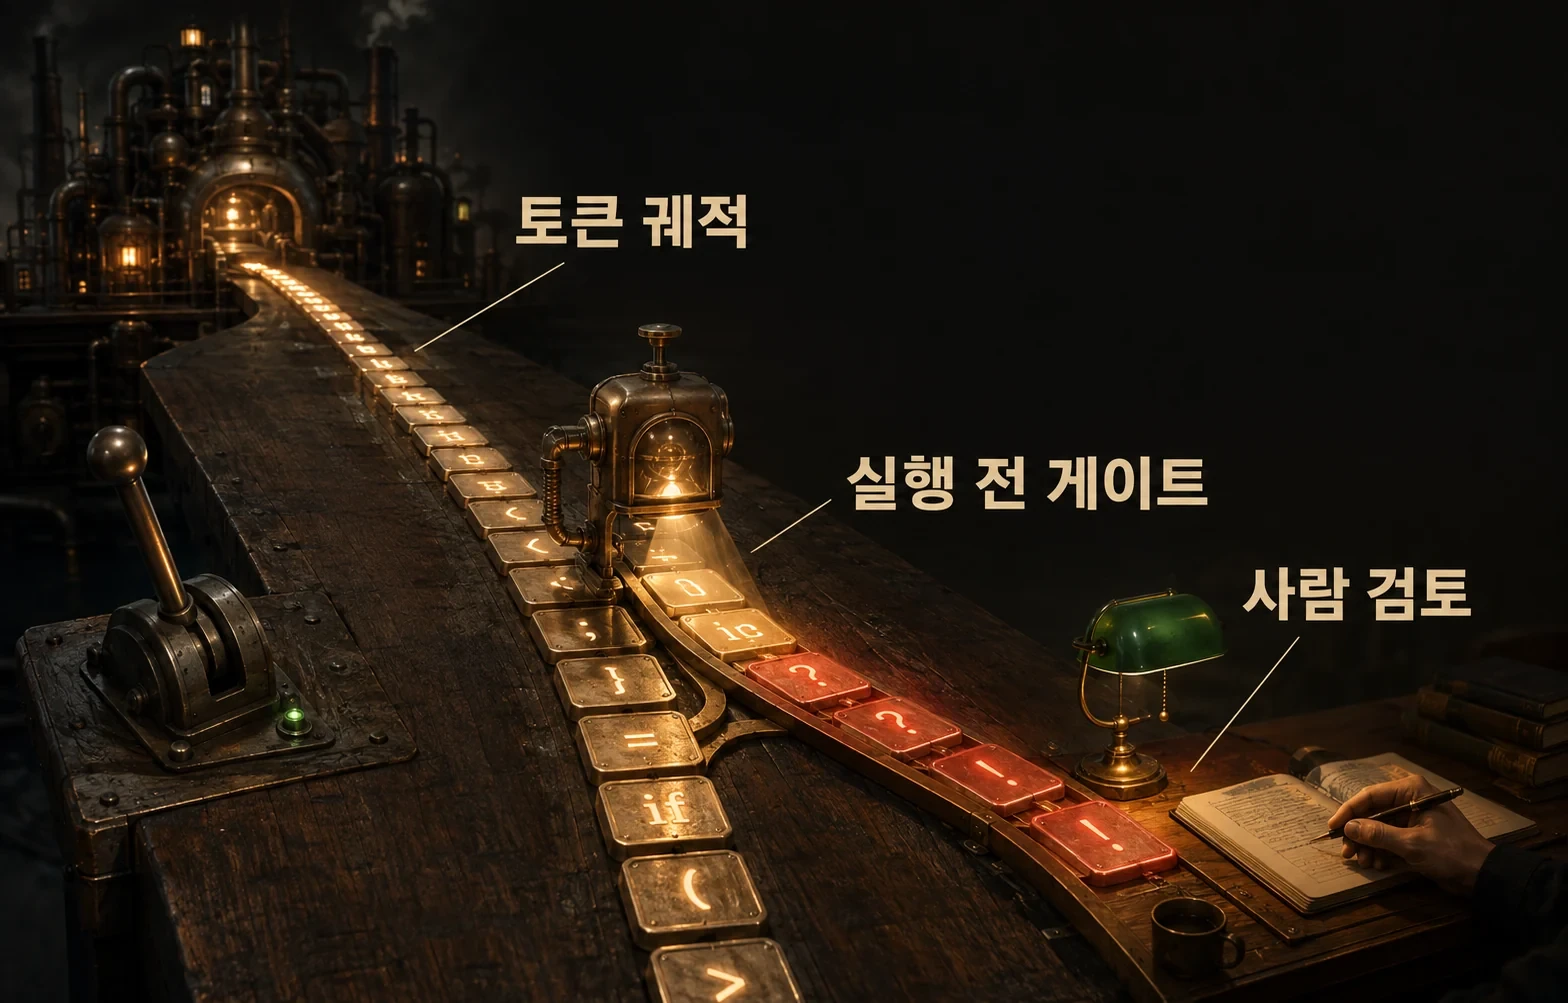
이 방법은 주 에이전트의 가중치나 활성값, logits를 들여다보지 않습니다. 작은 모델이 출력 토큰의 흐름을 읽고, 이 작업이 실행까지 갔을 때 틀릴 가능성을 점수화합니다. 점수가 낮으면 명령 실행을 막고 에이전트가 다시 계획하게 합니다.
이 구조가 흥미로운 이유는 모델을 바꾸지 않고도 안전 층을 붙일 수 있기 때문입니다. 기업은 이미 쓰는 에이전트와 도구 권한을 유지하면서, 실행 직전의 판단만 따로 감시할 수 있습니다. 반대로 게이트가 잘못 거부하면 정상 작업이 느려지고 비용이 늘 수 있습니다.
오류율과 토큰 비용을 함께 봐야 한다
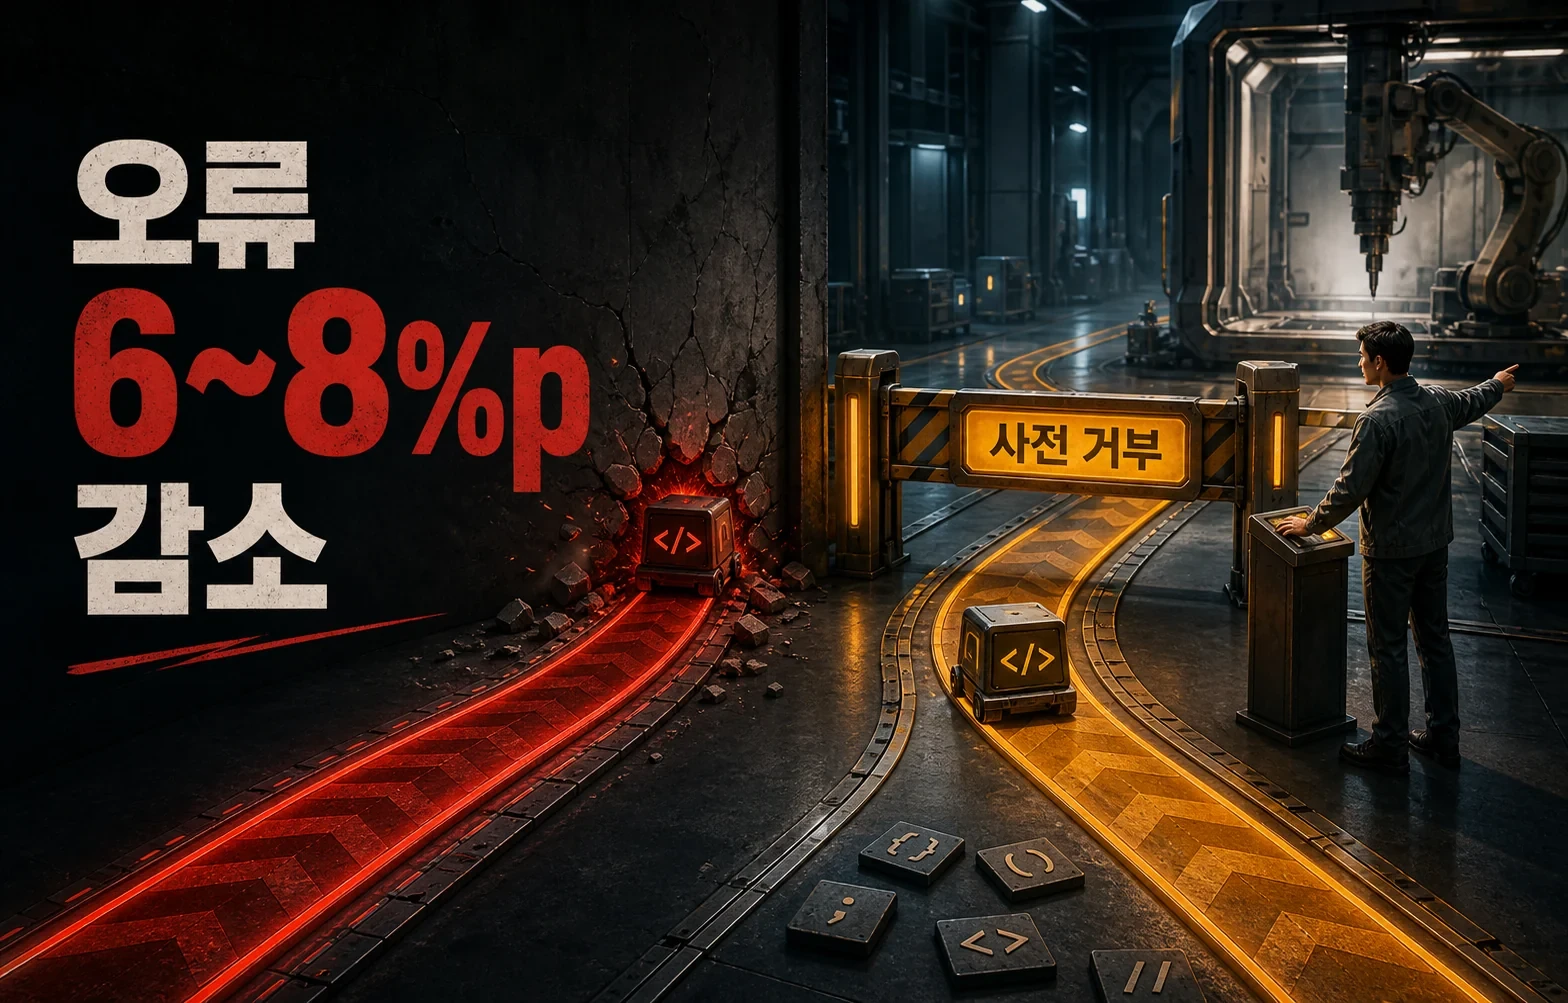
실험의 감소 폭은 서로 다른 지표입니다. 오류율 6~8%포인트는 작업 결과가 틀리는 비율의 변화이고, 토큰 비용 14~19%는 다시 시도하거나 긴 궤적을 처리하는 양의 변화입니다. 둘을 합쳐 “성능이 20% 좋아졌다”고 말하면 안 됩니다.
게이트가 실패 가능성이 높은 실행을 초기에 걸러내면, 뒤늦게 테스트를 돌리고 오류를 발견한 뒤 전체 계획을 다시 세우는 비용을 줄일 수 있습니다. 따라서 작은 모델의 정확도보다 큰 에이전트의 실행 실패를 얼마나 미리 구분하는지가 핵심입니다.
재시도보다 재계획이 싸질 때
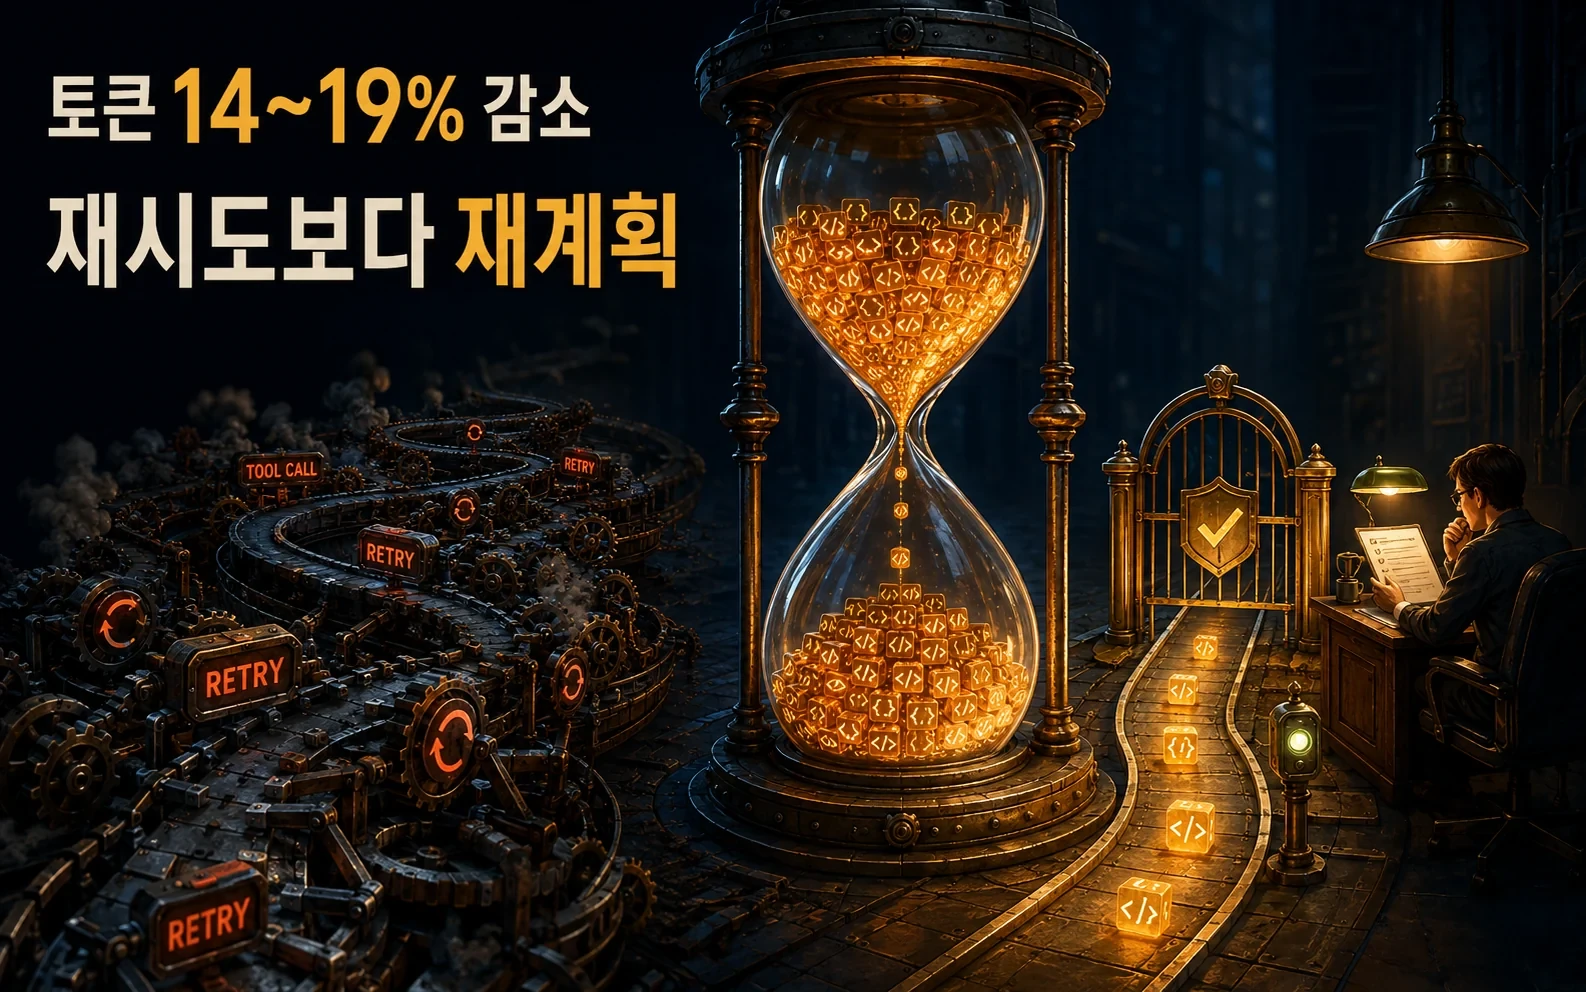
코딩 에이전트의 작업은 도구 호출이 이어지는 긴 경로입니다. 파일을 고치고 테스트를 실행하고 오류를 읽어 다시 수정합니다. 마지막 단계에서 잘못된 가정을 발견하면 이전 호출과 토큰을 모두 지불한 뒤 다시 돌아가야 합니다.
사전 게이트는 이 비용을 실행 전 판단 비용으로 바꾸는 장치입니다. 다만 모든 오류를 미리 알아내는 것은 아닙니다. 저장소의 특이한 규칙, 외부 서비스 응답, 테스트 데이터의 편향은 출력만 읽는 모델이 놓칠 수 있습니다.
아직 제품에 바로 적용할 수 없는 이유
프리프린트 결과를 실제 개발팀에 그대로 이식하려면 더 확인할 조건이 있습니다. 에이전트 종류가 바뀌어도 같은 임계값이 통하는지, 저장소와 도구 분포가 달라도 오탐이 감당 가능한지, 실패한 실행을 어떤 기준으로 재계획하는지 봐야 합니다.
그래도 방향은 분명합니다. AI 코딩의 품질 관리는 모델 하나의 정답률만 재는 일이 아니라, 실행으로 넘어가기 전 위험한 궤적을 얼마나 싸게 가려내는지로 확장되고 있습니다. 작은 draft 모델은 주인공이 아니라, 큰 모델의 행동을 지연 없이 검사하는 운영 계층에 가깝습니다.