쇼핑 추천에서 고객이 고른 상품보다 한 단계 비싸고 적합한 대안을 제시하는 일은 생각보다 어렵습니다. “더 비싼 상품”만 고르면 엉뚱한 업셀링이 되고, 비슷한 상품만 고르면 가격·기능 차이를 설명할 수 없습니다. 2026년 9월 5일 공개된 연구는 큰 언어 모델의 비교·추론을 작은 추천 모델에 옮기는 방법을 제안했습니다.
17,200개 상품 쌍과 29개 상품 유형을 사용했고, 15.5M 파라미터 학생 모델이 추론 증류를 거쳤습니다. 네 등급 분류 AUC는 라벨만 학습한 0.912에서 추론 증류 후 0.924로 올라갔습니다. 연구 조건의 결과이며 실제 쇼핑몰 매출이나 고객 만족을 증명한 수치는 아닙니다.
큰 모델은 교사, 작은 모델은 운영자
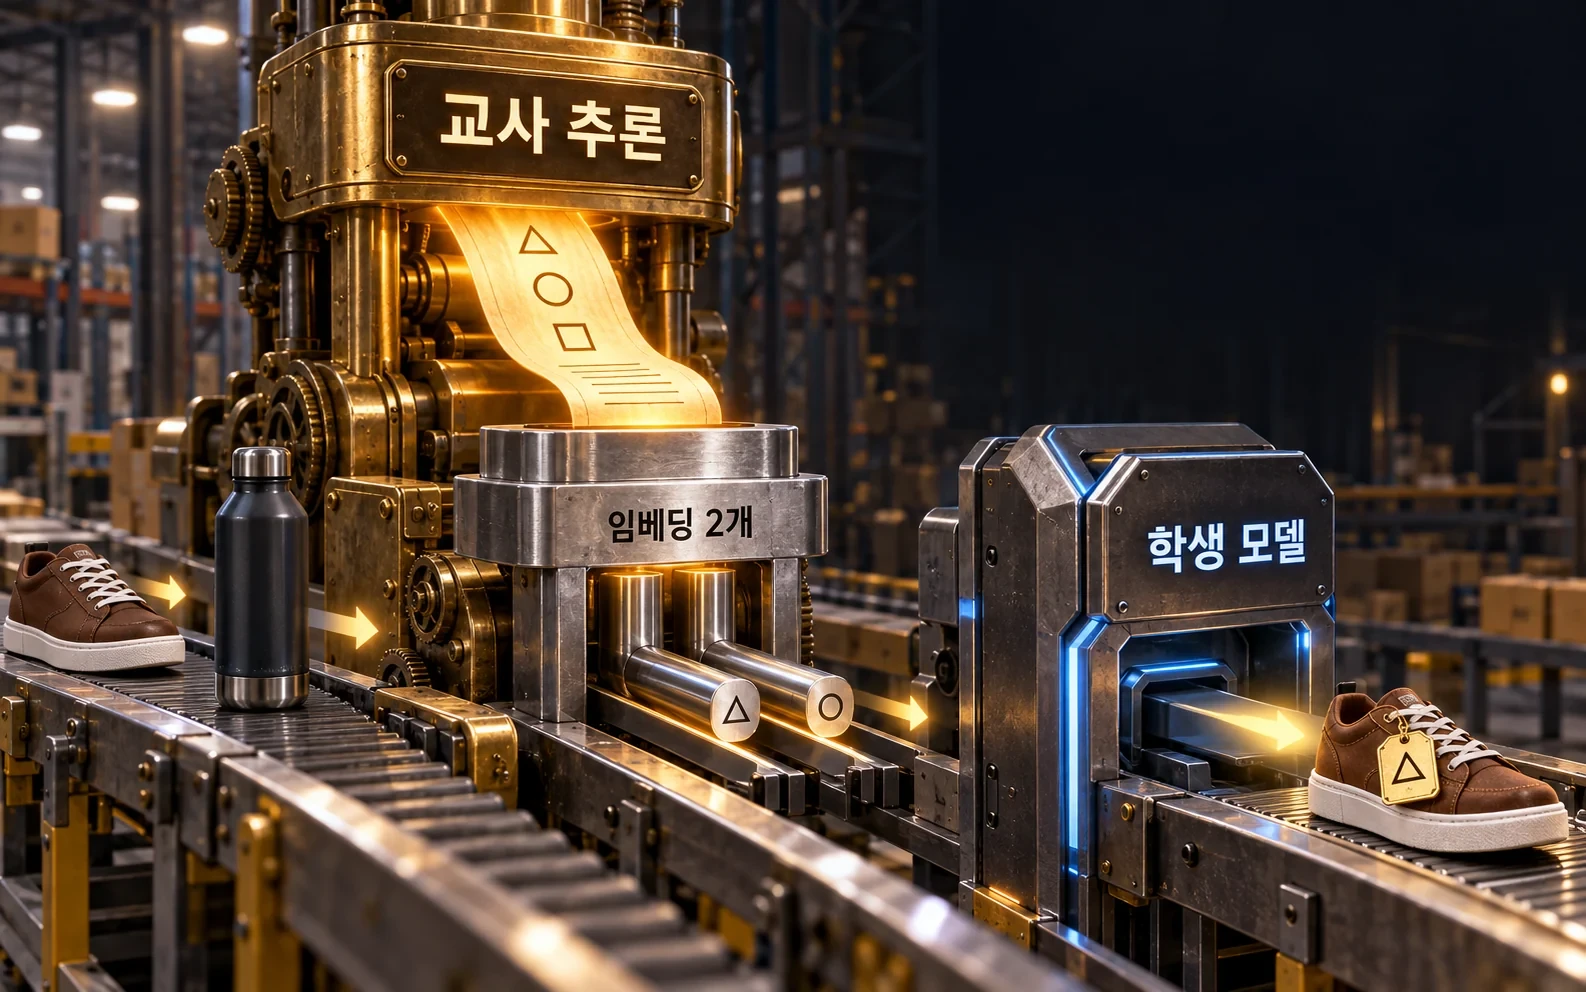
큰 모델은 두 상품을 비교하고 왜 한 상품이 더 나은 선택인지 설명하는 추론을 만듭니다. 작은 학생 모델은 이 설명과 정답 라벨을 함께 배운 뒤, 실제 추천 시점에는 768차원 상품 임베딩을 이용해 네 등급을 분류합니다.
이 방식의 핵심은 추론을 매번 호출하지 않는다는 점입니다. 큰 모델은 학습 과정에서만 사용하고, 운영 시에는 1,550만 파라미터 모델이 판단합니다. 지연과 호출 비용을 줄일 수 있지만, 교사가 만든 설명의 편향과 카탈로그 변화도 학생에게 옮겨질 수 있습니다.
AUC 0.912에서 0.924로
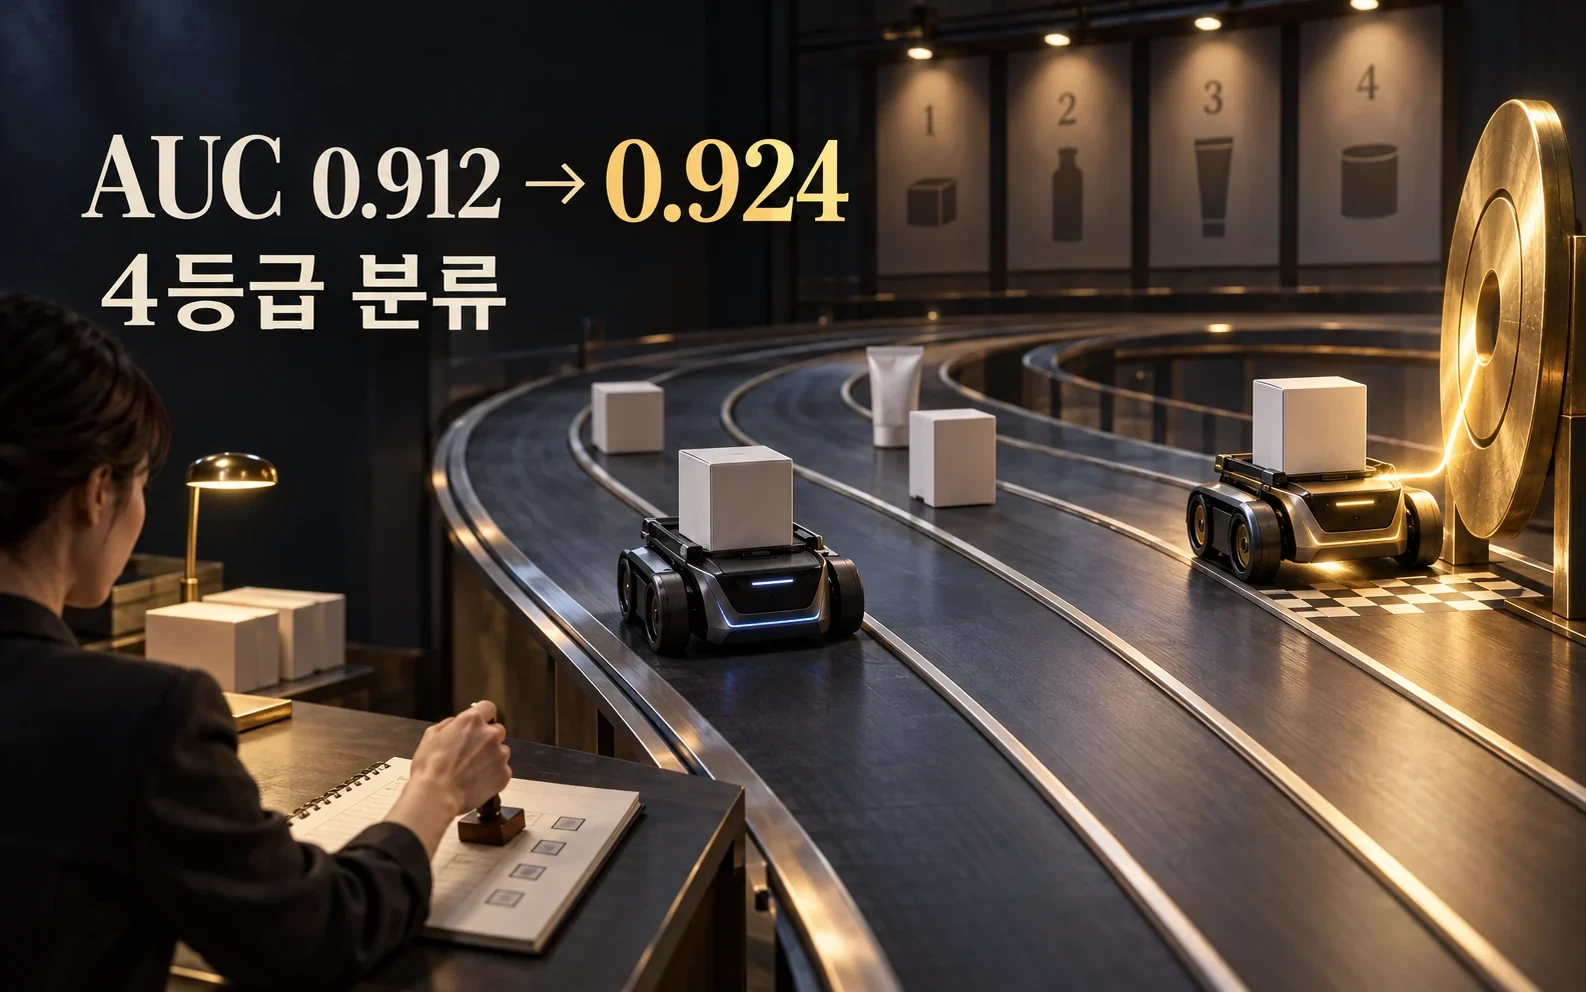
라벨만 학습한 모델의 4등급 분류 AUC는 0.912, 추론 증류를 추가한 모델은 0.924였습니다. 상승폭은 0.012로, 작은 모델이 큰 모델과 똑같아졌다는 뜻이 아닙니다. 정답 라벨만 보는 것보다 상품 간 관계를 설명한 정보가 분류 기준을 보완했다는 뜻에 가깝습니다.
AUC 하나로 추천 품질을 끝낼 수도 없습니다. 가격이 실제로 더 비싼지, 재고가 있는지, 고객이 왜 추천을 받았는지, 추천 뒤 구매와 반품이 어떻게 변했는지를 별도로 봐야 합니다.
상품 유형마다 기준을 바꾼다
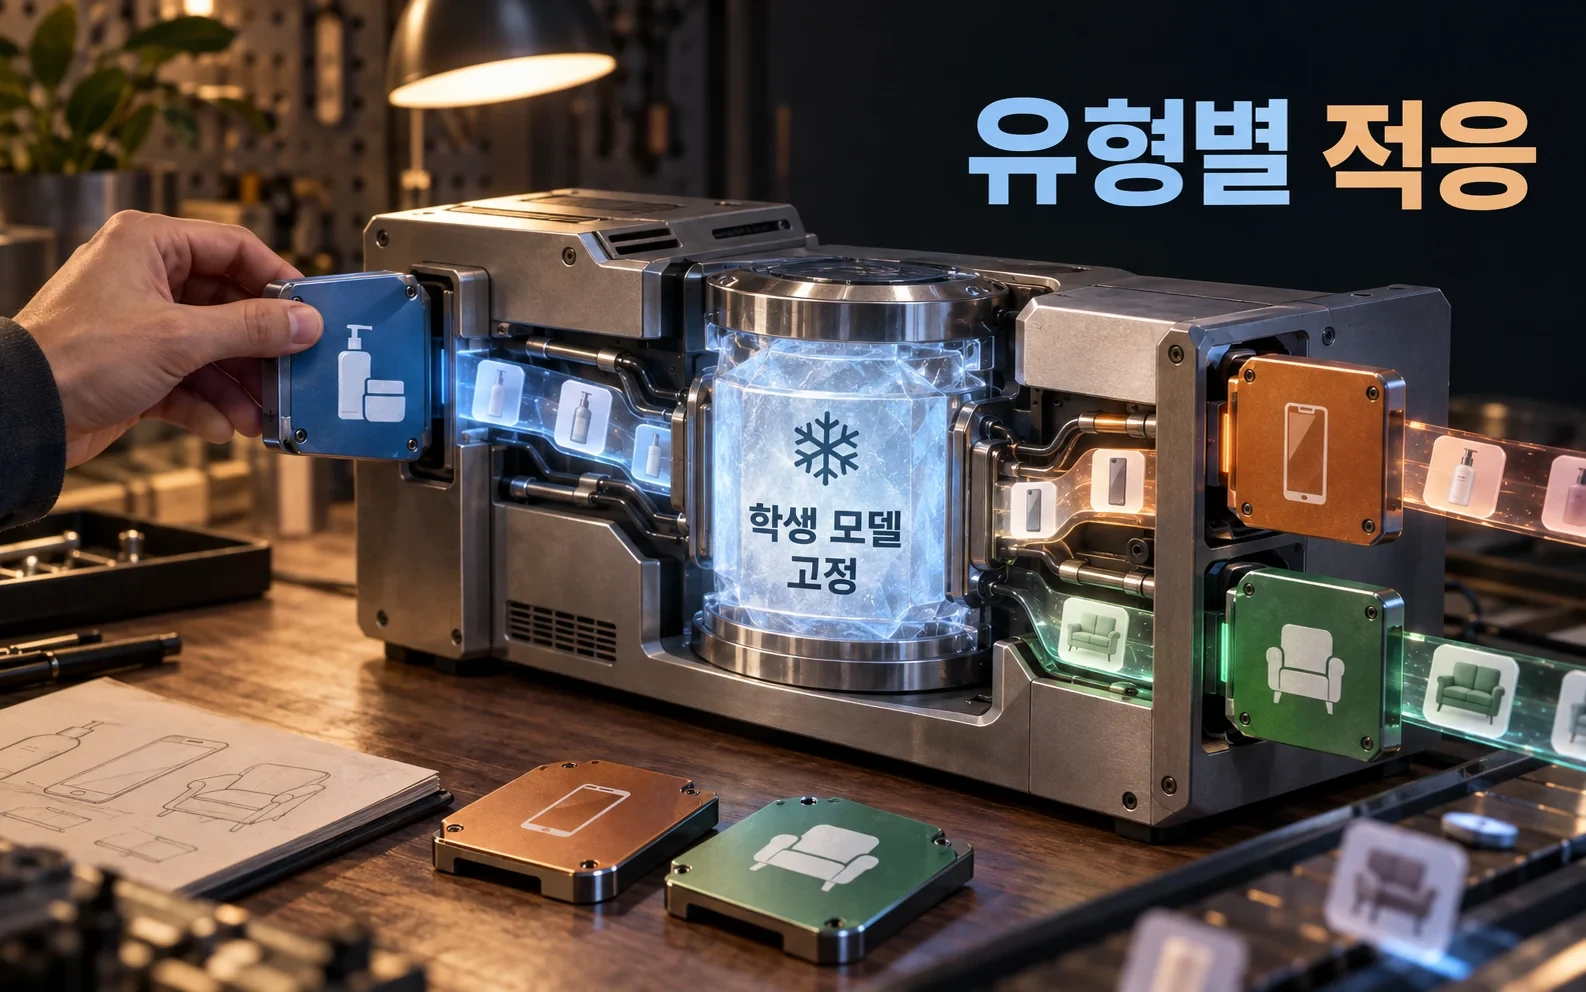
연구는 상품 유형별 테스트 시점 적응도 사용했습니다. 휴대전화와 가구처럼 상품의 비교 기준이 다른데 하나의 규칙을 강제로 적용하면 추천이 어긋날 수 있기 때문입니다. 유형별로 최근 분포를 반영하되, 모델 전체를 다시 학습하지 않고 분류 경계를 조정하는 접근입니다.
이것은 카탈로그 운영에서 중요한 문제입니다. 새 브랜드와 가격대가 들어오거나 유행이 바뀌면 어제의 “한 단계 위”가 오늘의 좋은 추천이 아닐 수 있습니다. 적응은 편리하지만, 어떤 기준으로 경계를 바꿨는지 기록하지 않으면 결과를 감사하기 어렵습니다.
실제 배포에서 남은 질문
이번 연구는 추천 모델의 추론 비용을 줄이는 설계를 보여 줬지만, 실제 카탈로그의 재고·가격·마진·반품까지 연결한 배포 결과는 아닙니다. 상품 쌍 데이터가 특정 유형에 치우쳤는지, 고객의 예산과 선호를 반영했는지, 비싼 상품을 권하는 것이 정말 고객에게 더 적합한지 확인해야 합니다.
그래도 방향은 명확합니다. 대형 모델의 강점은 모든 요청에 직접 답하는 데만 있는 것이 아니라, 비교와 설명의 흔적을 만들어 작은 모델의 운영 비용을 낮추는 데도 있습니다. 추천 시스템의 다음 경쟁은 모델 크기보다, 큰 모델의 판단을 얼마나 투명하게 증류하고 실제 재고 변화에 맞게 갱신하는가에서 갈릴 수 있습니다.