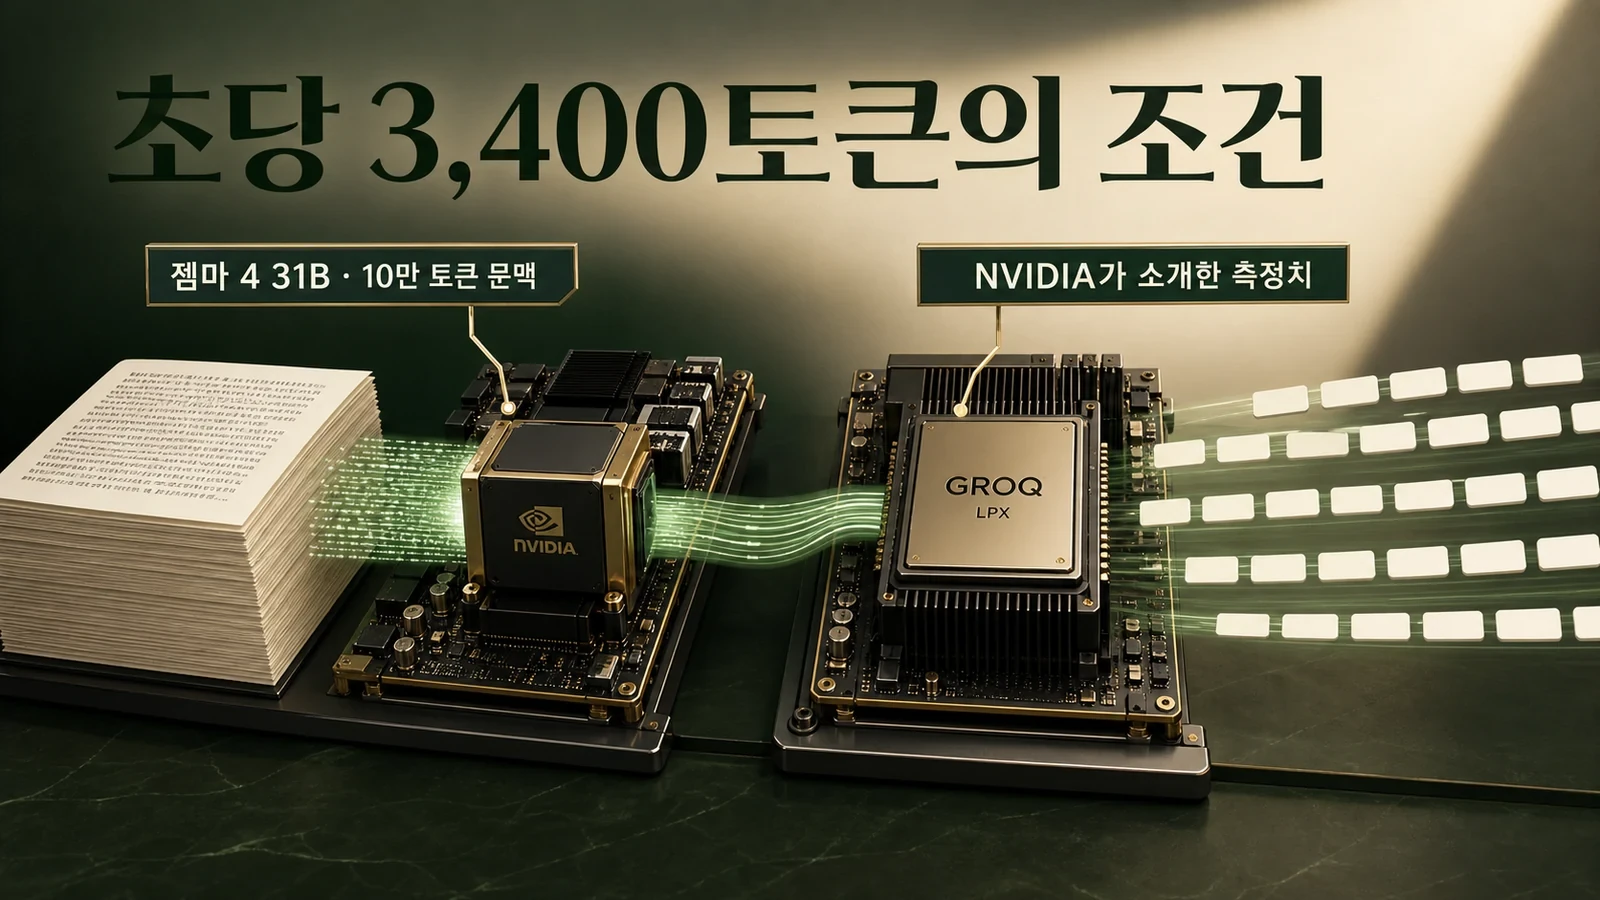
AI가 답을 순식간에 써주면 사람이 읽는 속도가 더 느릴 때도 있죠. 그런데 AI가 사람에게 보여줄 답변이 아니라 다음 작업에 쓸 코드를 만드는 중이라면 어떨까요. 코드를 다 써야 실행할 수 있고, 실행 결과가 나와야 그다음 일을 시작할 수 있습니다. 여러 단계를 거쳐 일하는 AI에게는 답을 빨리 만드는 능력이 작업 전체의 대기 시간을 줄이는 데 도움이 됩니다.
엔비디아가 8월 24일 본격 양산을 발표한 ‘그로크 3 LPX’도 이 부분을 겨냥합니다. GPU가 맡는 모든 일을 대신하는 제품이라기보다, AI의 출력 생성을 빠르게 처리하도록 만든 가속기입니다.
입력 처리와 답변 생성의 차이
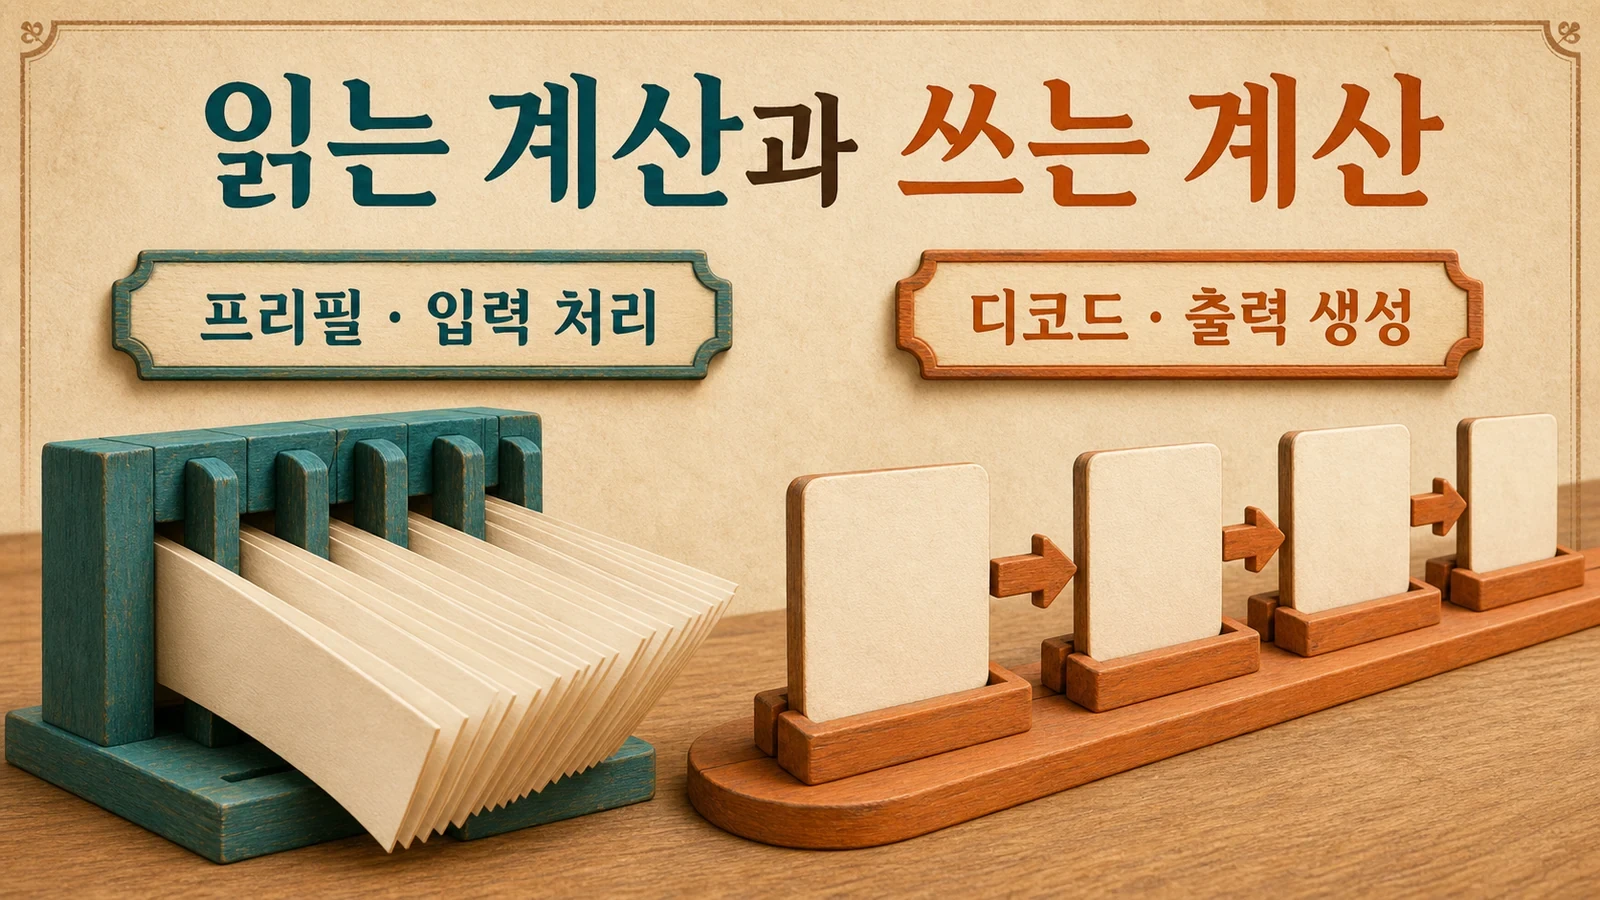
AI에게 긴 문서를 주고 요약을 부탁했다고 해볼게요. 모델은 먼저 전달받은 문서의 내용을 처리합니다. 이 단계를 ‘프리필’이라고 합니다. 그 내용을 바탕으로 답을 조금씩 만들어가는 단계는 ‘디코드’라고 부르고요. 사용자가 보기에는 하나의 응답이지만, 안에서는 성격이 다른 계산이 이어지는 겁니다.
입력 문서는 이미 주어져 있으니 한꺼번에 처리할 여지가 큽니다. 반면 답을 만들어갈 때는 앞서 생성한 내용이 다음 내용에 영향을 줍니다. 순서를 따라 계산해야 하는 일이 많은 거죠. 네비우스의 기술 설명도 긴 문맥 처리와 빠른 생성을 나눠 다룹니다. 두 단계에 서로 잘 맞는 장비를 붙이면, 한 종류의 장비로 모든 계산을 처리할 때와 다른 성능을 기대할 수 있습니다.
빠른 메모리와 용량의 절충
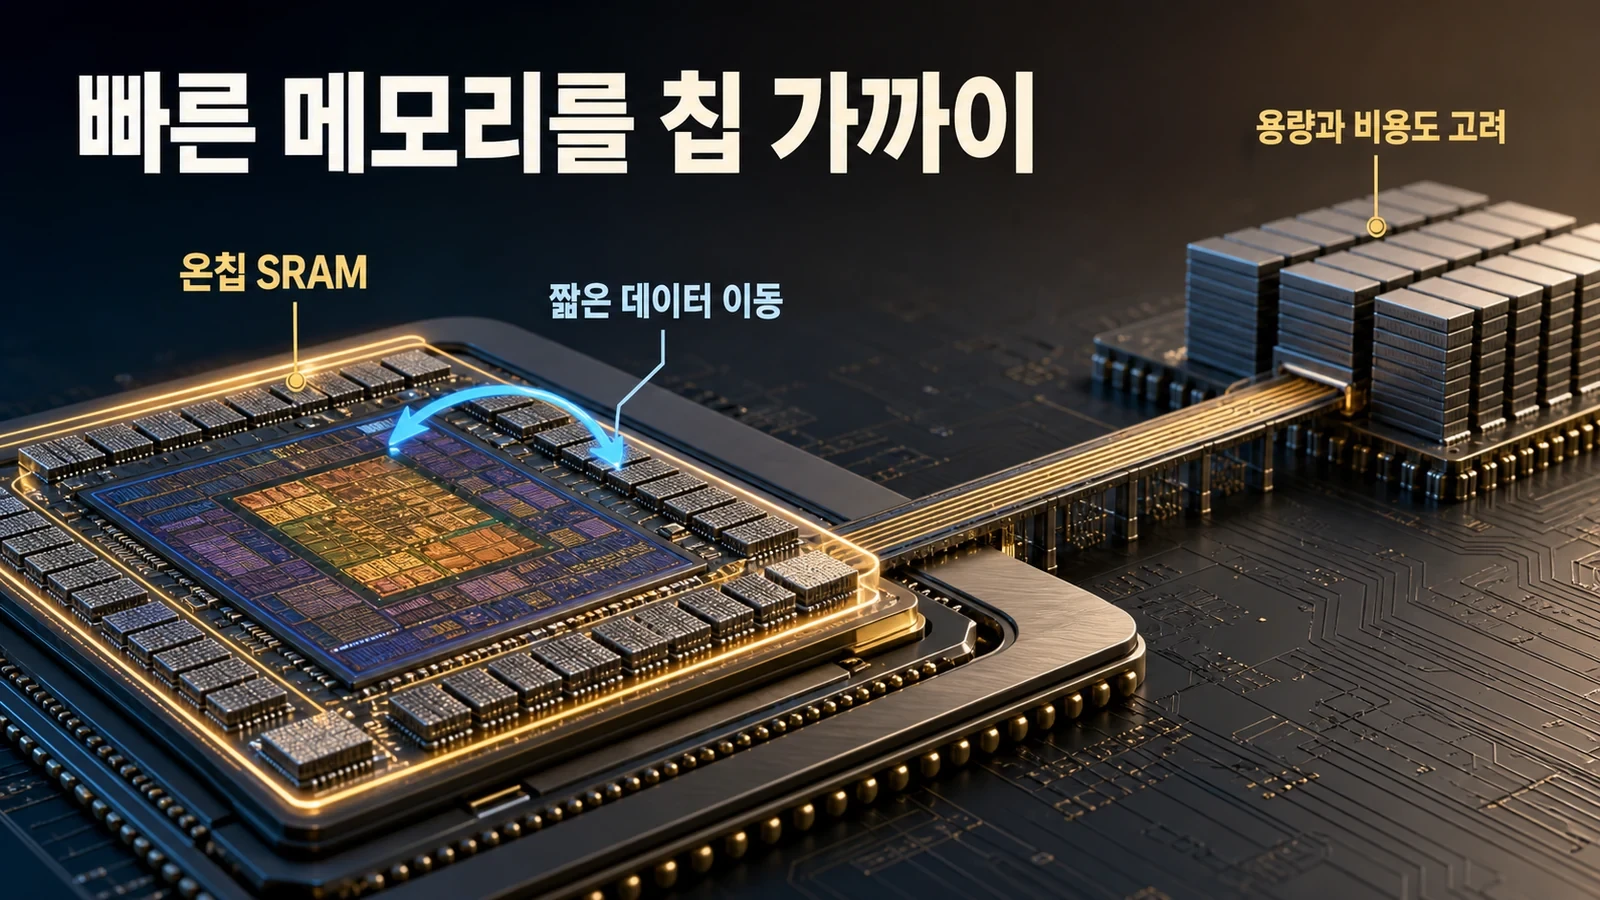
그로크 계열 가속기는 칩 안에 SRAM이라는 빠른 메모리를 많이 배치합니다. 계산에 필요한 정보를 멀리서 가져오느라 기다리는 시간을 줄이기 위해서예요. 자주 보는 자료를 책상 바로 옆에 펼쳐두는 것에 비유할 수 있습니다. 다만 실제 장비에서는 칩 하나의 메모리뿐 아니라 여러 칩이 정보를 주고받는 방식도 함께 맞춰야 합니다.
네비우스가 공개한 구성은 랙 하나에 가속기 256개, 이 칩들에 들어 있는 SRAM을 모두 합쳐 128GB입니다. 칩 하나에 128GB가 들어 있는 구성은 아니에요. 큰 모델을 실행하려면 여러 칩의 메모리를 활용하고 계산을 나눠 맡겨야 합니다. 빠른 메모리가 주는 이점과 그만한 용량을 마련하는 데 필요한 장비를 함께 따져야 실제 비용도 판단할 수 있겠죠.
초당 3,400토큰의 측정 조건
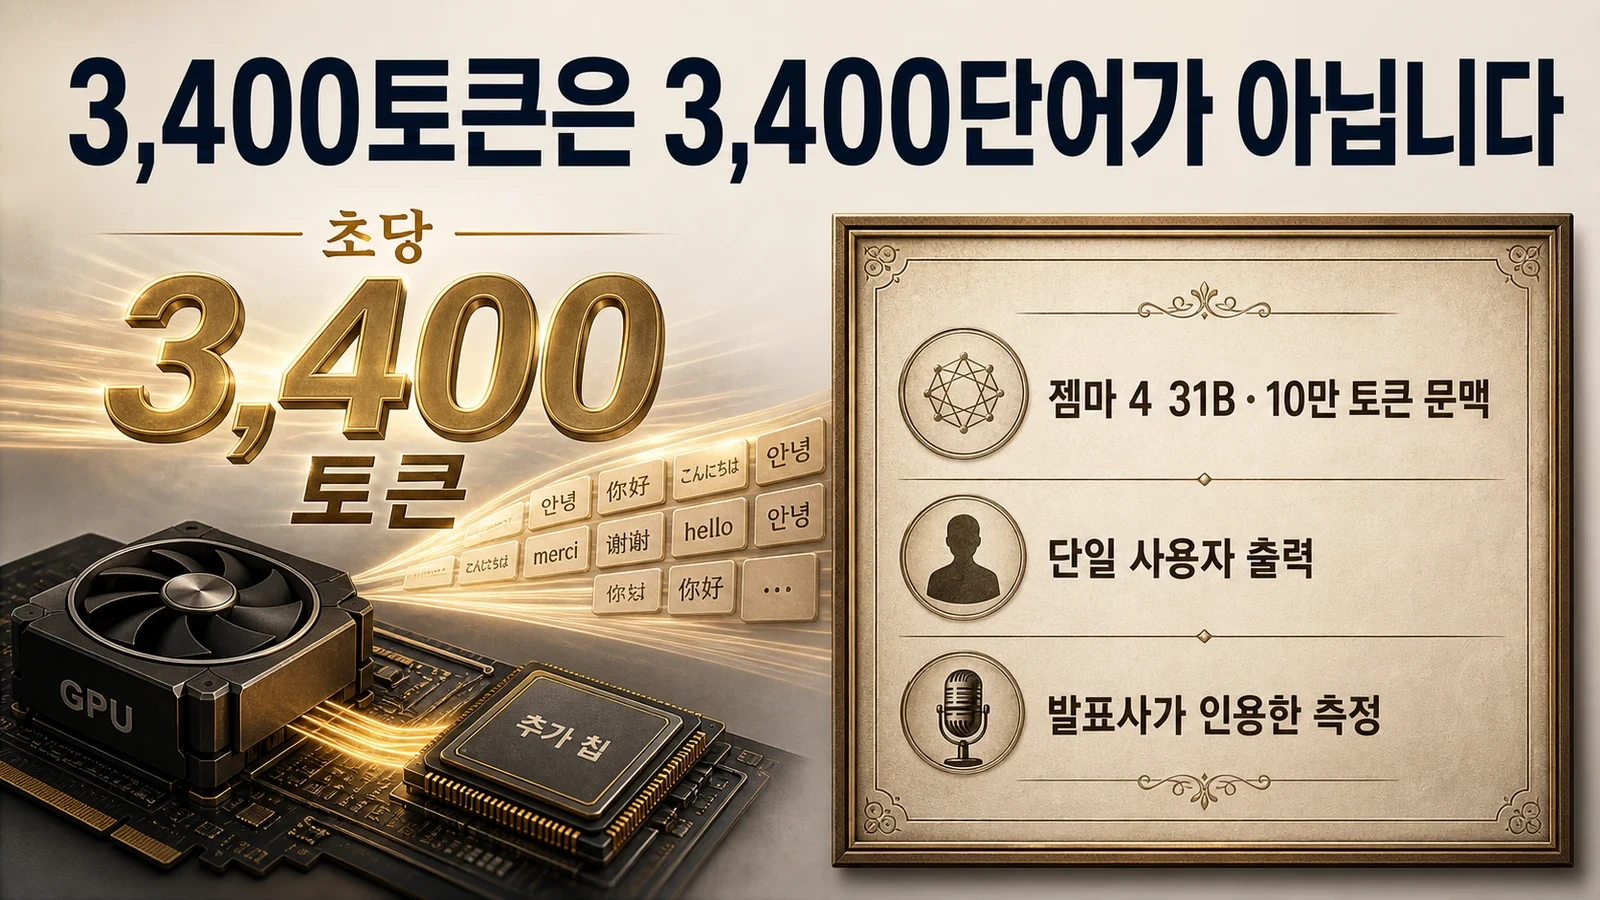
이번 발표에서 눈에 띄는 수치는 초당 3,400토큰입니다. 엔비디아는 아티피셜 애널리시스의 측정 결과를 인용해, ‘젬마 4 31B’ 모델을 10만 토큰 길이의 문맥에서 실행했을 때 사용자 한 명에게 이 속도로 출력했다고 소개했습니다. 어떤 모델을 어떤 입력 조건에서 돌렸는지까지 붙여 읽어야 하는 숫자입니다.
토큰은 AI가 처리하는 글의 조각입니다. 한국어 한 글자나 영어 한 단어와 딱 맞아떨어지지 않아서, 3,400토큰을 그대로 3,400단어로 바꾸기는 어렵습니다. 모델이나 입력 길이가 달라져도 속도가 달라질 수 있고요. 이번 조사에서는 평가기관의 원시 측정 기록까지 확보하지 못했으므로, 여기서 소개하는 값은 엔비디아가 인용한 측정치입니다.
이 속도가 빨라지면 출력이 시작된 뒤의 기다림은 줄일 수 있습니다. 다만 첫 출력까지 걸리는 시간이나, 중간에 웹을 검색하고 코드를 실행하는 시간까지 함께 줄어드는 것은 아닙니다. 우리가 실제로 맡길 작업에서 어디에 시간이 많이 쓰이는지 알면, 빠른 토큰 생성이 얼마나 도움이 될지도 더 분명하게 볼 수 있습니다.
양산 이후의 서비스 도입
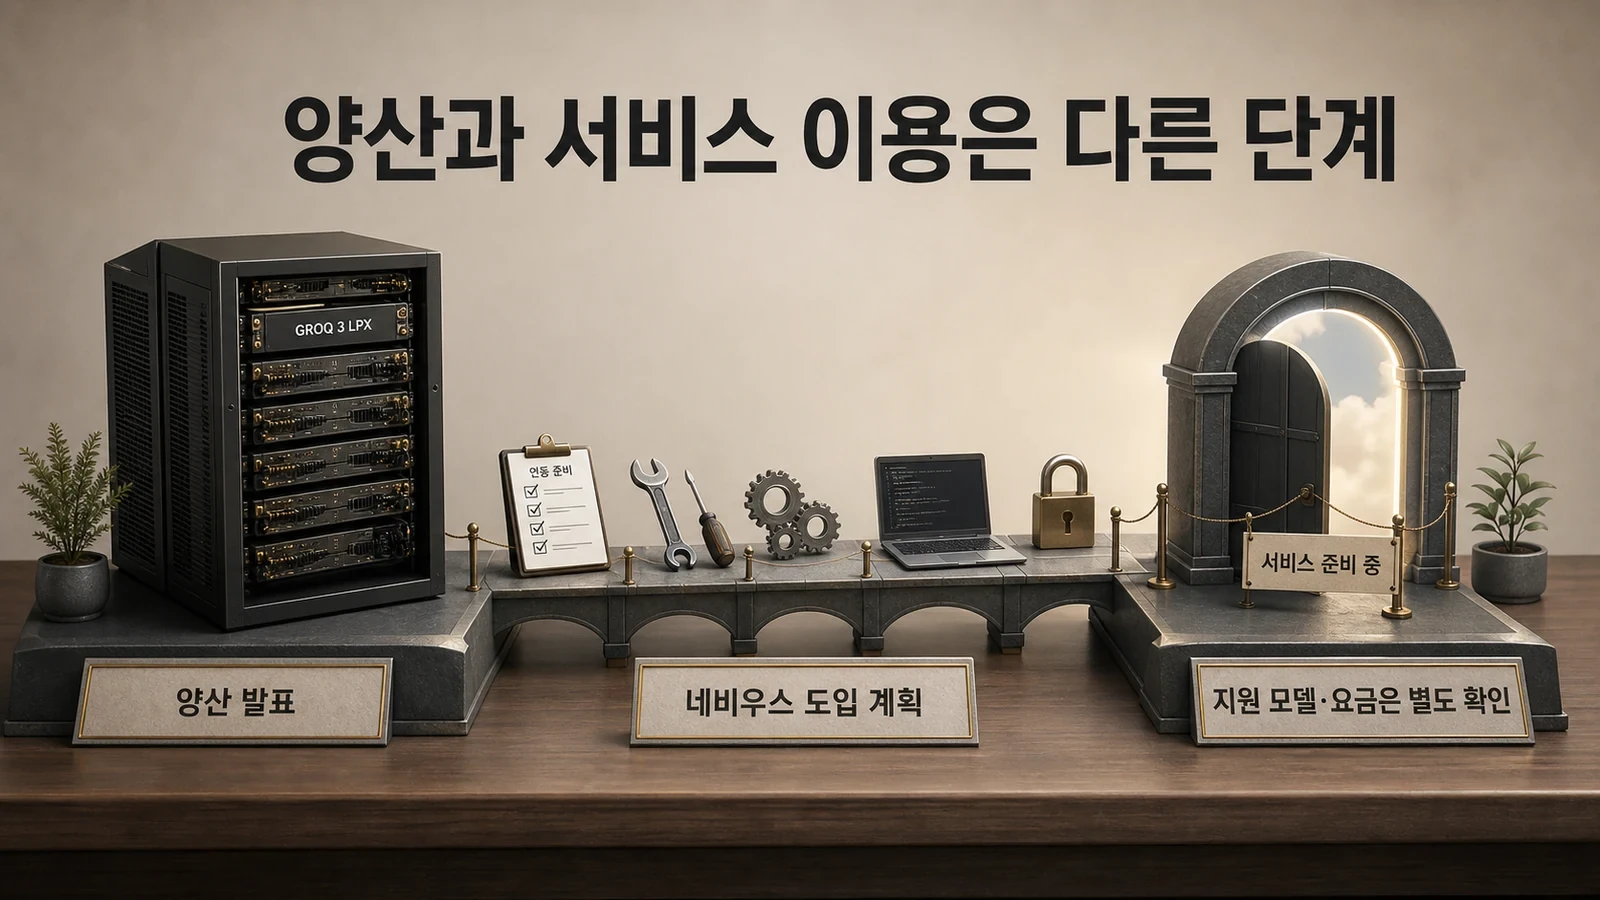
네비우스는 자사 추론 서비스인 토큰 팩토리에 LPX를 도입할 계획입니다. 기존 개발 환경을 유지하면서 이용할 수 있도록 하되, 초기에는 일부 모델을 지원한다는 설명입니다. 장비가 양산된다는 소식 다음으로 개발자가 궁금할 것은 자신이 쓰는 모델을 언제, 얼마에 이용할 수 있느냐일 텐데요. 구체적인 일반 제공 일정과 요금은 아직 별도로 확인해야 합니다.
이번 제품을 보면 AI 인프라를 구성하는 방식이 조금 더 세분화되고 있다는 걸 알 수 있습니다. 긴 입력을 처리하는 장비와 빠르게 출력을 만드는 장비를 조합해 각자의 장점을 쓰려는 겁니다. 실제 서비스에서도 그 조합이 작업 시간을 줄여주고 비용까지 납득할 만하다면, 개발자에게는 선택지가 하나 더 생기는 셈입니다.