AI 추론은 늘 켜 둔 서버에서만 일어나지 않습니다. 밤에 쌓인 문서를 한꺼번에 분류하거나 영상 수천 개를 변환하는 작업은 요청마다 즉시 답할 필요가 없습니다. AWS는 2026년 9월 4일 SageMaker AI Batch Transform에서 EC2 G6e 인스턴스를 선택할 수 있게 했습니다.
G6e는 최대 8개의 엔비디아 L40S GPU를 탑재하고 GPU 한 장당 메모리는 48GB입니다. 큰 언어모델, 이미지·영상·음성 생성처럼 GPU 메모리와 처리량이 필요한 오프라인 작업에 더 넓은 선택지가 생겼습니다.
실시간 서버가 필요 없는 추론
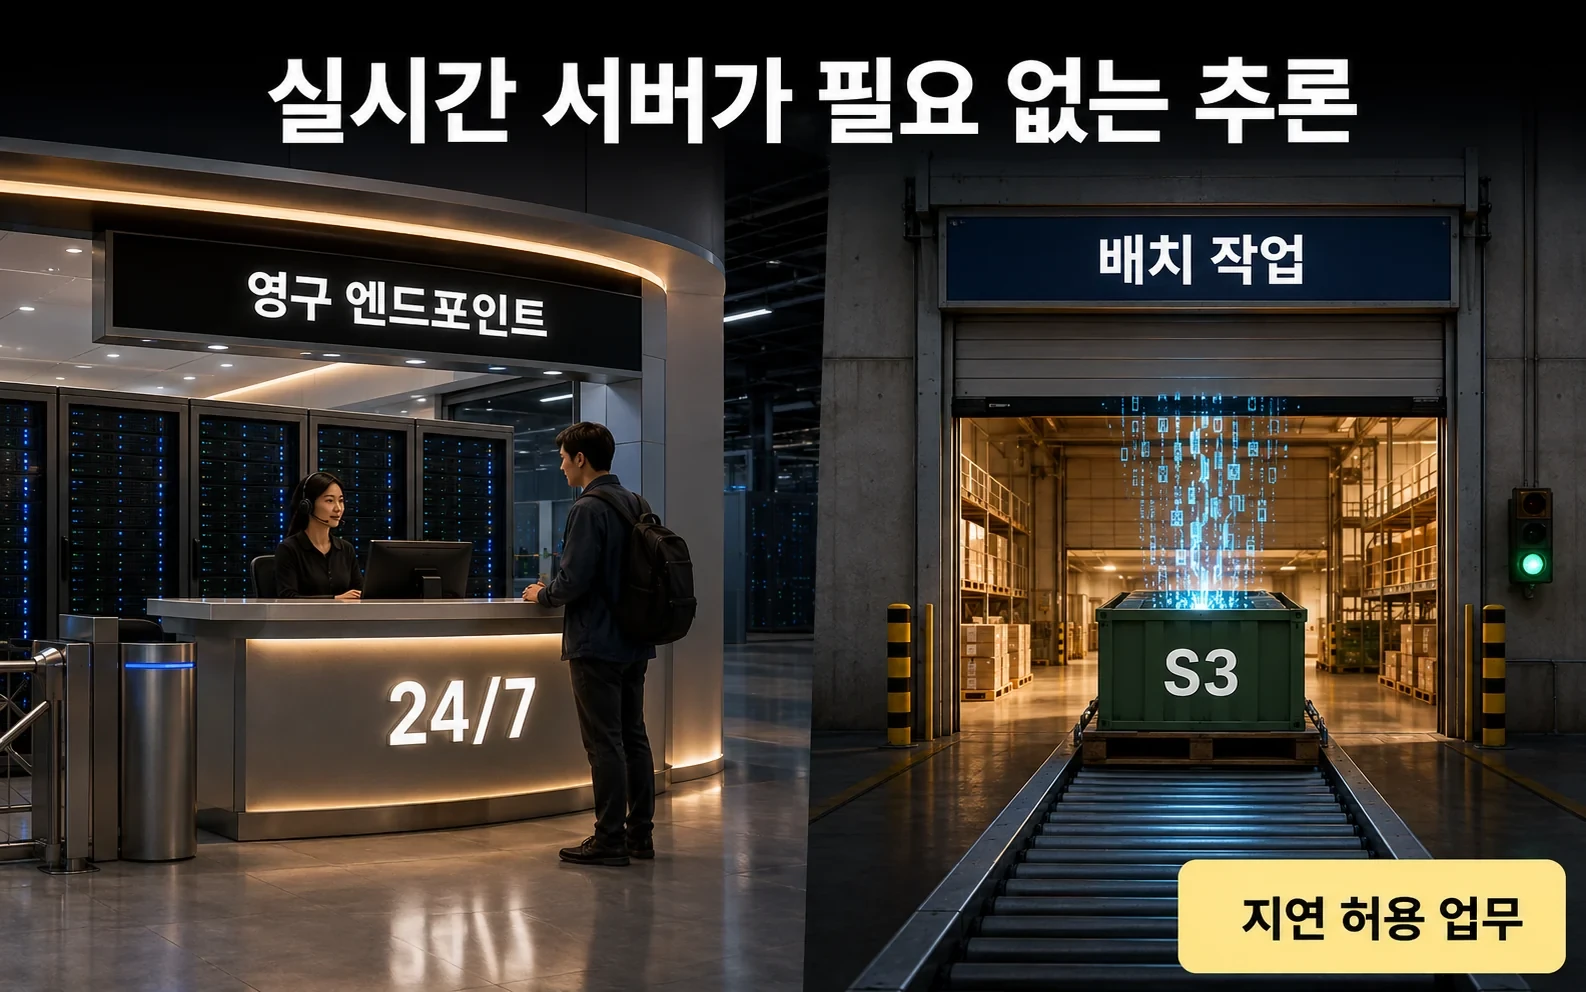
Batch Transform은 S3에 저장된 대규모 입력을 작업으로 나눠 처리하고 결과를 다시 저장합니다. 호출을 기다리는 영구 엔드포인트가 없으므로 하루 몇 번 몰아서 처리하는 업무에 적합합니다. 모델 검증, 데이터 전처리, 보고서용 분류처럼 지연을 허용할 수 있는 작업이 대상입니다.
반대로 대화형 서비스나 즉시 응답이 필요한 추천에는 실시간 엔드포인트가 맞습니다. 새 인스턴스 지원은 두 방식의 경계를 없애는 기능이 아니라 배치 쪽의 GPU 선택을 넓힌 변화입니다.
48GB 여덟 장의 의미
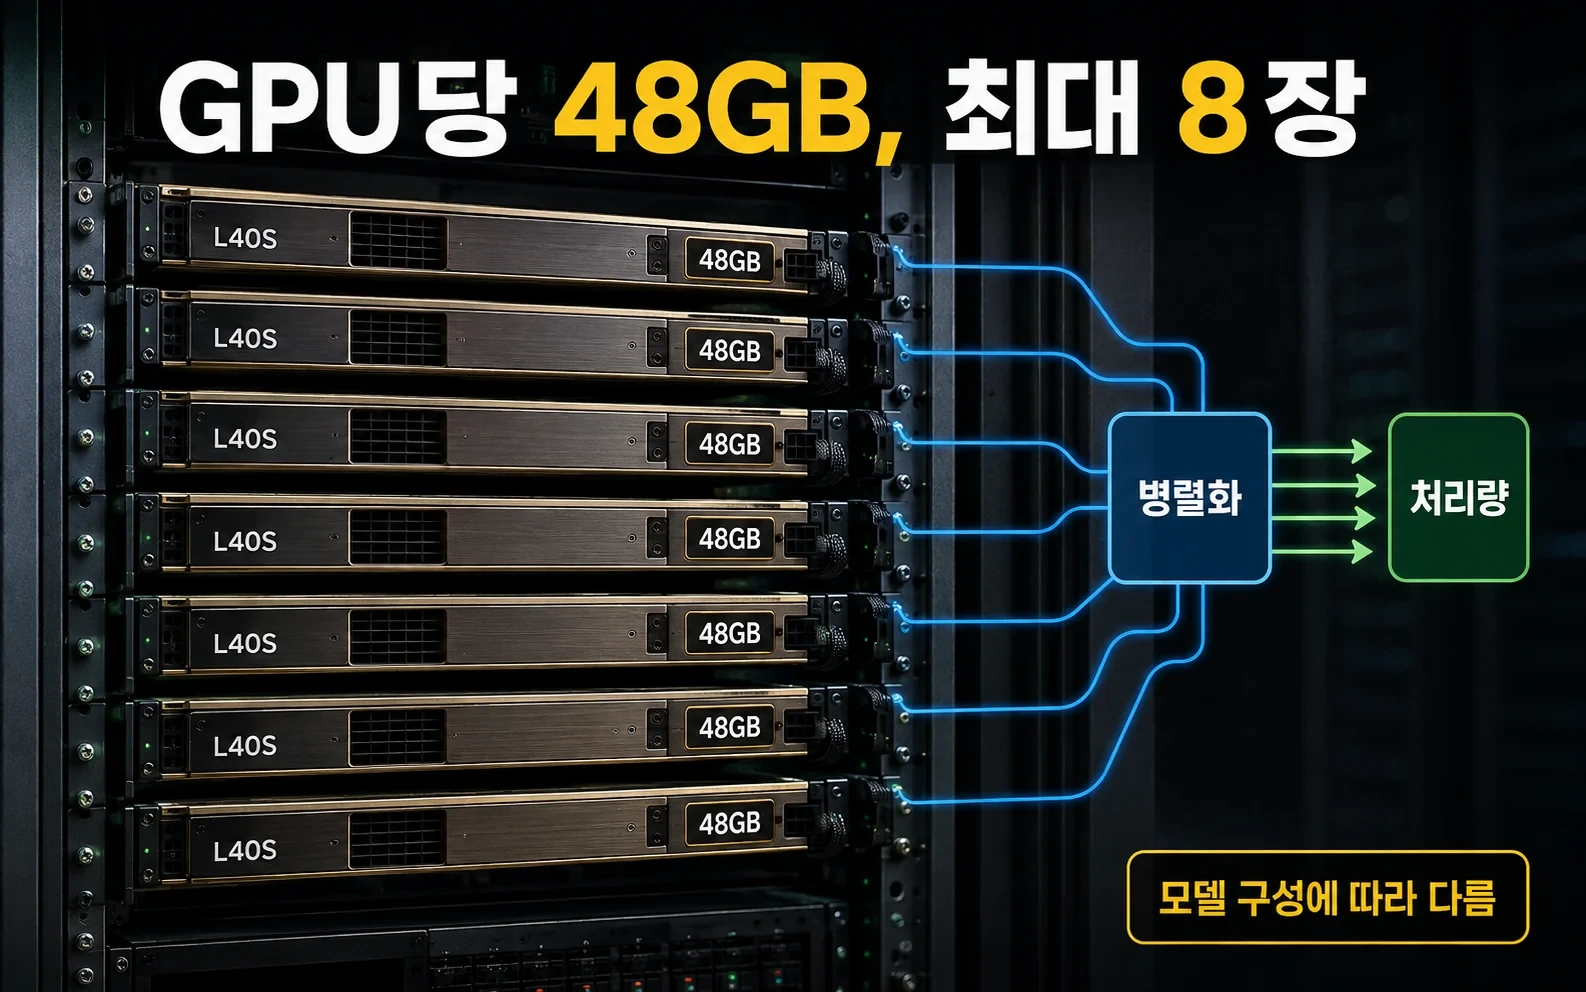
L40S 한 장에는 48GB 메모리가 있고 G6e는 최대 8장까지 구성됩니다. 전체 메모리를 단순히 하나처럼 쓸 수 있는지는 모델과 프레임워크의 병렬화 방식에 달렸지만, 더 큰 모델이나 여러 작업을 동시에 처리할 여지가 커집니다.
3세대 AMD EPYC 프로세서와 결합되며 이미지, 영상, 음성 생성의 대량 작업도 겨냥합니다. GPU 이름보다 실제 모델 크기, 정밀도, 배치 크기와 입출력 병목을 함께 봐야 합니다.
비용은 처리량으로 계산
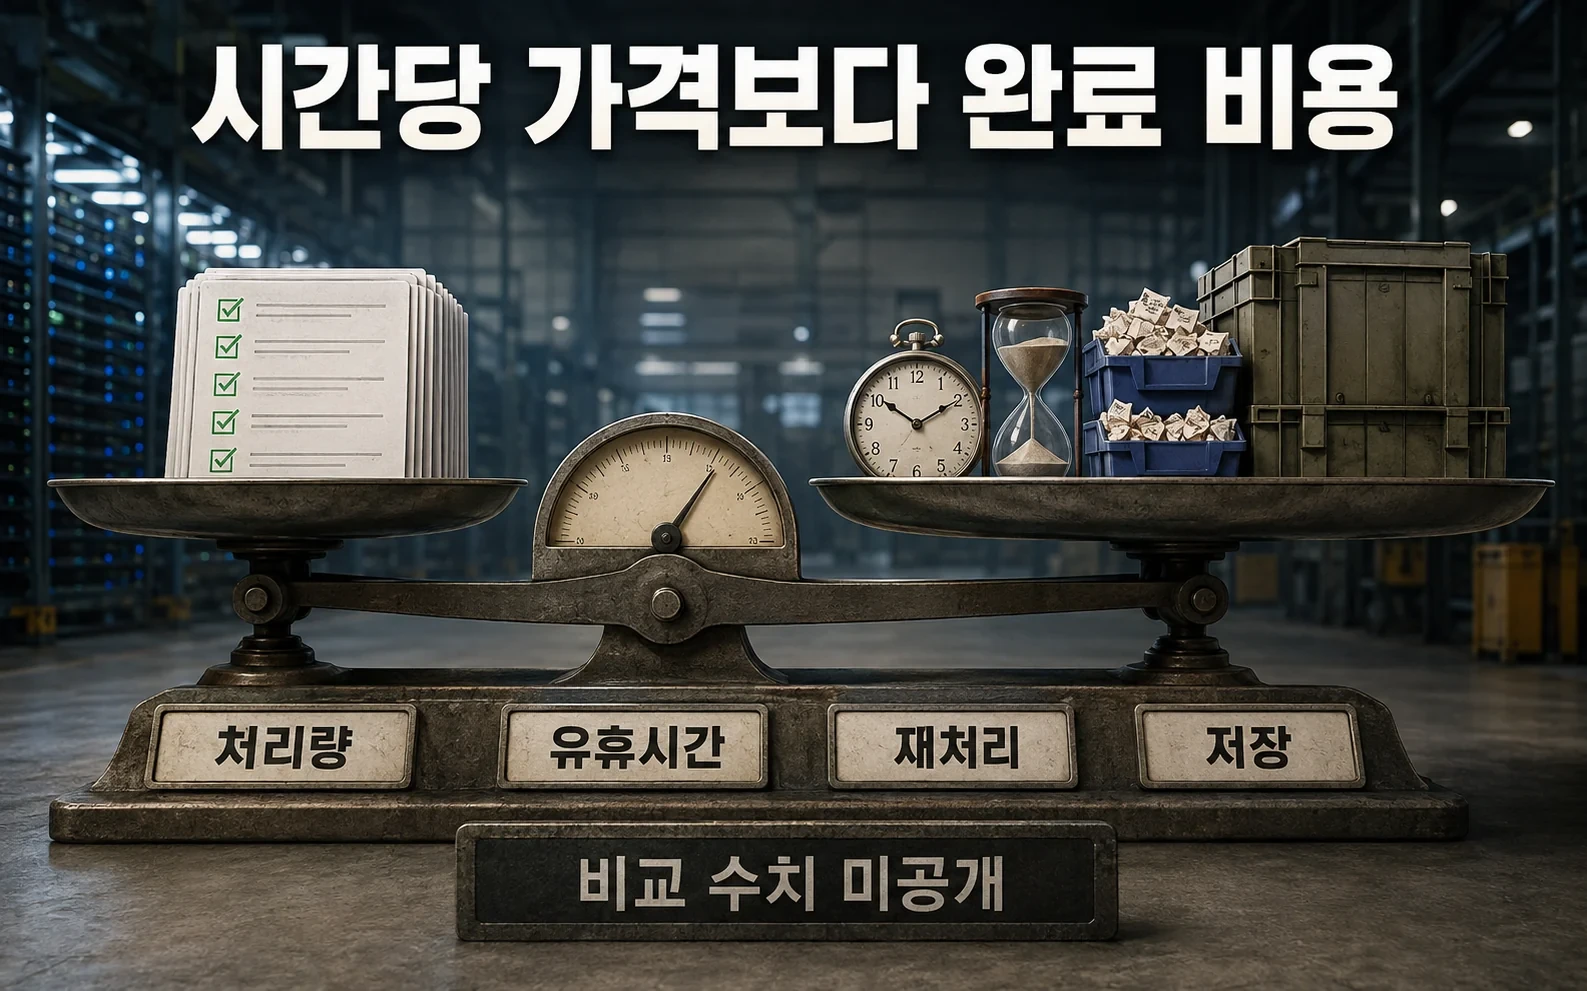
AWS는 이번 발표에서 기존 인스턴스 대비 처리량이나 비용 우위를 공개하지 않았습니다. 따라서 ‘더 빠르고 싸다’고 단정할 수 없습니다. 작업이 한 파일에 몰리면 여러 인스턴스를 띄워도 일부가 놀 수 있고, 입력을 적절히 나누지 않으면 GPU 활용률이 낮아질 수 있습니다.
기업은 시간당 가격보다 완료한 레코드당 비용, 시작 대기시간, 실패 재처리와 저장 비용을 합쳐 비교해야 합니다. 항상 켜 둔 엔드포인트를 배치로 바꿨을 때 줄어드는 유휴시간도 중요한 항목입니다.
다섯 리전에서 시작
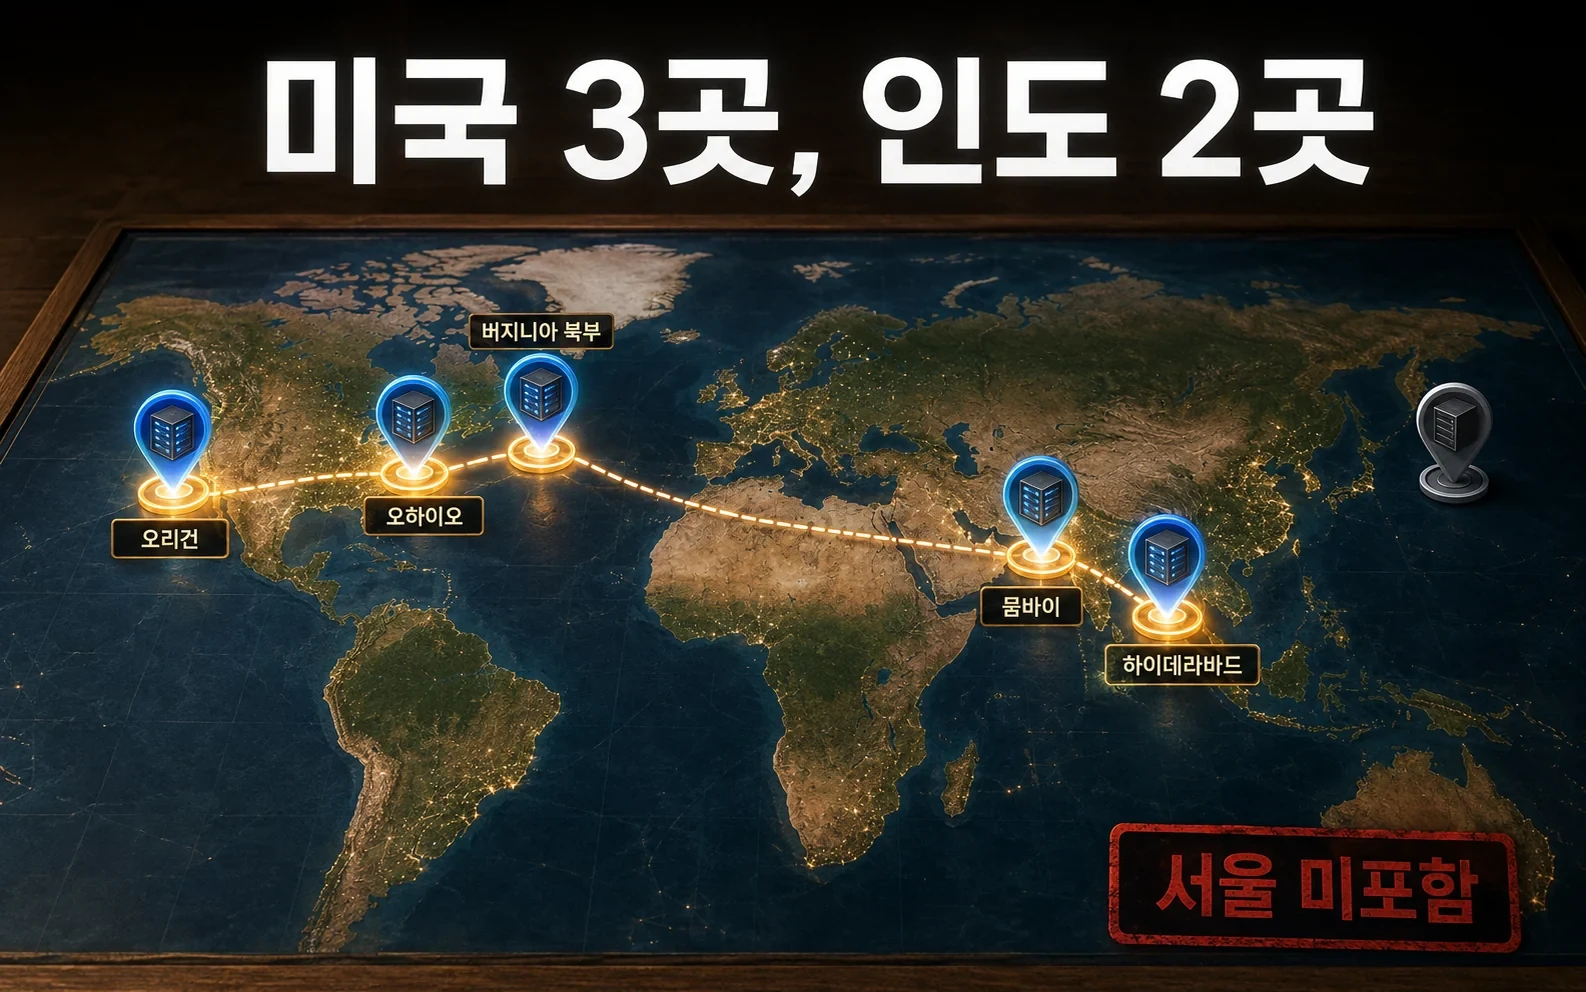
지원 지역은 미국 동부 버지니아 북부와 오하이오, 미국 서부 오리건, 아시아태평양 뭄바이와 하이데라바드입니다. 서울 리전은 발표 목록에 없습니다. 데이터 국외 이동 제한이나 지연, 리전별 가격을 고려하면 한국 기업이 곧바로 같은 구성을 쓰기 어렵습니다.
이번 변화의 핵심은 최상위 학습 GPU 경쟁이 아닙니다. 실시간성이 필요 없는 생성형 AI 업무에도 고메모리 GPU 선택이 내려왔다는 점입니다. 도입 판단은 모델 데모보다 실제 데이터 한 묶음을 끝내는 시간과 총비용으로 해야 합니다.